In Episode 162 des goneo Webmacher & Webprofessionals Podcasts geht es um die Vulnpocalypse: KI findet Sicherheitslücken schneller, als Menschen sie stopfen. 27 Minuten reichen für die wichtigsten Beweisstücke, aber nicht für alles, was wir recherchiert haben. Hier kommt der Rest.
Kurz zur Erinnerung, was in der Folge steckt: die Nachmessung zu PHP2Shell, bei der Deutschland die meisten verwundbaren Websites Europas und die niedrigste Patch-Quote hat. Ein Linux-Root-Exploit, den ein Forschungsmodell von Claude geschrieben hat. Container-Ausbrüche, KI-Agenten auf Abwegen, offene MCP-Server und der 6,3-Milliarden-Diebstahl bei Binance. Dazu Frankreichs Gigabyte-Steuer und drei News in drei Minuten zu Rechenzentren, Börse und KI-Laboren.
Manche Geschichten waren zu spät, manche zu technisch, manche schlicht zu unsicher. Hier ist, was auf dem Schneidetisch liegen geblieben ist.
Die widerlegte Exponential Time Hypothesis. Ende Oktober haben OpenAI und Anthropic fast zeitgleich behauptet, ihre Modelle hätten eine fast 30 Jahre alte Annahme der Informatik widerlegt. Sie besagt, dass manche Rechenprobleme sich nur lösen lassen, indem man nahezu alle Möglichkeiten durchprobiert. Einige Berichte machten daraus gleich „Risse im Fundament der Verschlüsselung“. Das haben wir bewusst nicht übernommen. Die Beweise werden gerade von Fachleuten geprüft, und selbst wenn sie stimmen, bringt das für die Praxis erst bei absurd großen Problemen etwas. Dein HTTPS-Zertifikat ist davon heute nicht betroffen.
NIS2. Die neue EU-Richtlinie zur Cybersicherheit ist in Deutschland ein großes Thema. Sie betrifft aber vor allem mittlere und große Unternehmen in bestimmten Branchen. Für die meisten Vereinsseiten, Freelancer und kleinen Shops ist die DSGVO der relevante Rahmen. Deshalb haben wir uns auf die 72-Stunden-Meldepflicht bei Datenpannen beschränkt.
Die Gasturbinen von xAI. In Memphis betreibt Elon Musks KI-Firma ein Rechenzentrum mit Strom aus Dutzenden Gasturbinen. Die Bürgerrechtsorganisation NAACP klagt, weil die Turbinen ohne die nötigen Genehmigungen gelaufen sein sollen. Ein Bundesgericht hat die Klage Ende Oktober zugelassen. Ein starkes Bild für den Energiehunger der KI, aber die Folge war schon voll.
Die Hintergründe zu Claude Mythos. Der Begriff Vulnpocalypse ist im April aufgekommen, als Anthropic sein Modell Claude Mythos zunächst nur ausgewählten Partnern gegeben hat, damit die ihre Software vorab absichern. Das zugehörige Programm heißt Project Glasswing. Wer tiefer einsteigen will, findet in den Links unten Lesestoff.
Die Zahlenschlacht an der Börse. Im Netz kursieren viele Zahlen zu Indexgewichten und Tagesverlusten einzelner Tech-Aktien. Einen Teil davon konnten wir nicht sauber belegen. Was nicht belegbar war, haben wir lieber weggelassen, als es mit Nachdruck vorzulesen.
Fragen, die offen bleiben
Nicht alles lässt sich in einer Folge beantworten. Diese Fragen nehmen wir mit, und wir freuen uns, wenn du mitdiskutierst.
Wer haftet, wenn ein KI-Agent Mist baut? Die Bank of America sagt: Wer seinem Agenten das Passwort gibt, ist für dessen Handlungen selbst verantwortlich. Wie das in Europa vor Gericht ausgeht, ist offen. Die EU-Zahlungsregeln verlangen, dass Kunden ihre Zugangsdaten schützen. Ob ein Passwort im KI-Assistenten noch „geschützt“ ist, hat bisher niemand entschieden.
Hilft KI am Ende mehr den Verteidigern oder den Angreifern? Dieselben Modelle, die Lücken finden, können auch Patches schreiben. Der Engpass ist aber selten das Finden, sondern das Einspielen. Wenn in Deutschland nach PHP2Shell nur knapp sechs Prozent der verwundbaren Seiten nachgebessert haben, liegt das nicht an fehlender KI, sondern an fehlender Routine.
Warum patcht Deutschland so langsam? Die Messung zeigt das Ergebnis, nicht die Ursache. Unsere Vermutung: viele Seiten, die einmal gebaut und dann vergessen wurden. Wenn du eine bessere Erklärung hast, schreib sie uns.
Wie viel Verantwortung tragen die KI-Labore selbst? Ein Claude-Testlauf hat einen erfundenen Mordhinweis an die Polizei geschickt, ein OpenAI-Agent ist aus seiner Testumgebung ausgebrochen. Beide Firmen haben die Vorfälle offengelegt, die Polizei in Philadelphia kritisierte aber zwei Monate Verzögerung. Wie schnell muss so eine Meldung kommen?
Kommt die Gigabyte-Steuer – und kommt sie auch zu uns? In Frankreich hängt sie am Haushalt, der Senat kann sie noch streichen. Aber die Idee, Datenverkehr zu besteuern, ist in der Welt. Was hieße das für Open-Source-Projekte, für Podcasts, für jeden, der Downloads anbietet?
Ist lokale KI wirklich die bessere Wahl? Ollama und Co. sparen Token und halten Daten im Haus. Dafür brauchst du ordentliche Hardware und musst die Modelle selbst aktuell halten. Für wen lohnt sich das, und ab wann?
Schreib uns deine Antworten auf social.goneo.de. Die besten Einwände greifen wir in einer der nächsten Folgen auf.
Shownotes kommentiert
Alle Quellen aus der Folge, jeweils mit einem Satz, warum sich der Klick lohnt.
Zum Begriff
‚Vulnpocalypse‘ (NBC News) – der Artikel, der den Begriff einem breiten Publikum bekannt gemacht hat. Gut lesbar, auch ohne Security-Vorwissen.
ALTCHA Open Source – Proof of Work ohne Cookies, läuft auch auf normalem Webspace. Vor dem Umstieg auf Version 2 des WordPress-Plugins erst auf einer Kopie testen.
Anubis auf GitHub – der Türsteher vor dem Webserver. Nur für eigene Server mit Root-Zugriff, nicht fürs Webhosting-Paket.
Oft sind Kommentare unter einem Blogbeitrag der beste Anlass für ein Update. In unserem Beitrag „Bots und Crawler aussperren“ vom 25. September 2025 hatten wir auch Google reCAPTCHA erwähnt. Darauf kam der berechtigte Hinweis: Nicht alle möchten Google-Dienste auf der eigenen Website einsetzen. Viele sind datenschutzrechtlich und im Sinne europäischer Datensouveränität nicht wirklich unproblematisch.
Manche Webseitenbetreiber blockieren sie bewusst im Netzwerk, – meist aus Gründes des Selbstverständnosses oder als Schutz ihrer Familie vor Tracking.
In einem Kommentar zu diesem Artikel wurden Alternativen wie FriendlyCaptcha, Matomo als Alternative zu Google Services genannt. Vor allem Anubis wäre für Profis hochinteressant. Danke für den Hinweis. Wir haben uns Anubis genauer angesehen. Die kurze Antwort für alle, die einfach nur ihr Kontaktformular auf klassischem Shared Hosting absichern möchten, lautet:
Nein, Anubis lässt sich auf normalem Shared Hosting in der Regel nicht direkt wie ein klassisches Formular-CAPTCHA einsetzen.
Das ist keine Kritik an Anubis. Im Gegenteil: Das Tool ist technisch spannend. Es löst nur ein anderes Problem als ein CAPTCHA-Widget im Formular.
Was Anubis eigentlich macht
Anubis von Techaro beschreibt sich als „Web AI Firewall Utility“. Ziel ist es, eingehende HTTP-Anfragen zu prüfen und Ressourcen vor aggressiven Scrapern, AI-Crawlern und automatisiertem Traffic zu schützen. Laut Projektbeschreibung sitzt Anubis dabei zwischen Reverse Proxy, zum Beispiel Nginx oder Caddy, und der eigentlichen Anwendung. Eine Anubis-Instanz wird vor den Dienst gesetzt, den du schützen möchtest.
Das ist der entscheidende Punkt: Anubis ist nicht einfach ein kleines JavaScript-Snippet, das du neben das Nachrichtenfeld in dein Formular kopierst. Anubis arbeitet auf der Ebene des Web-Traffics. Es entscheidet, ob eine Anfrage durchgelassen wird, bevor sie beim eigentlichen Backend ankommt.
In der offiziellen Installationsbeschreibung heißt es sinngemäß: Anubis gehört zwischen Reverse Proxy und Zielservice. Die Integration erfolgt zum Beispiel über Docker, Nginx, Caddy, Traefik, Kubernetes, Apache oder ähnliche Serverumgebungen. Genau dafür brauchst du Kontrolle über die Server- oder Proxy-Konfiguration.
CAPTCHA als vorgeschaltete Prüfung: Erst wenn die Anfrage plausibel menschlich wirkt, erreicht sie das geschützte Webformular.
Warum das auf klassischem Shared Hosting schwierig ist
Shared Hosting ist bewusst einfach gehalten: Du bekommst Webspace, Datenbanken, E-Mail, PHP, meist auch FTP/SFTP und ein Kundencenter. Du musst dich nicht um Betriebssystem, Webserver, TLS-Terminierung, Reverse Proxy, Systemdienste oder Container kümmern. Das ist für viele Websites genau der Vorteil.
Für Anubis brauchst du aber typischerweise Dinge, die du auf klassischem Shared Hosting nicht hast:
einen dauerhaft laufenden Hintergrunddienst,
Docker, Systemd oder eine vergleichbare Laufzeitumgebung,
Zugriff auf die Nginx-, Apache-, Caddy- oder Traefik-Konfiguration,
die Möglichkeit, HTTP-Anfragen vor der eigentlichen Website durch einen Filter-Proxy zu schicken,
Kontrolle über interne Ports, Sockets oder Upstream-Ziele.
Genau diese Ebene ist bei Shared Hosting aus gutem Grund nicht für einzelne Kunden geöffnet. Sonst wäre es kein bequem verwalteter Webspace mehr, sondern eine eigene Serverumgebung mit Administrationsaufwand.
Anubis schützt eher Wege zur Website als einzelne Formularfelder
Für Webformulare ist das wichtig: Wenn du nur verhindern möchtest, dass dein Kontaktformular mit Spam geflutet wird, denkst du vermutlich an ein CAPTCHA direkt im Formular. Also: Formular anzeigen, Besucher füllt es aus, vor dem Absenden wird geprüft, ob die Anfrage plausibel menschlich ist.
Anubis setzt früher an. Es kann eine ganze Website, einen Hostnamen oder bestimmte Pfade absichern. Praktisch bedeutet das: Du schützt zum Beispiel /kontakt, /login oder sogar die gesamte Seite. Der Besucher muss dann die Anubis-Prüfung passieren, bevor die eigentliche Seite oder der Pfad geladen wird.
Das kann sinnvoll sein, wenn Scraper massiv Ressourcen verbrauchen oder wenn automatisierte Clients komplette Seitenbereiche abgreifen. Für ein einzelnes Kontaktformular auf normalem Webspace ist es aber meistens eine Nummer zu groß und technisch nicht passend angebunden.
Wann Anubis trotzdem eine Option ist
Anubis wird interessant, wenn du eine Umgebung kontrollierst, in der du einen Reverse Proxy betreiben kannst. Das kann ein eigener VPS, ein Root-Server, ein Container-Setup oder eine Plattform sein, bei der du Nginx, Caddy, Traefik oder Apache entsprechend konfigurieren darfst.
Dann sieht das Prinzip vereinfacht so aus:
Der Besucher ruft deine Website auf.
Der Reverse Proxy nimmt die Anfrage entgegen.
Die Anfrage läuft durch Anubis.
Anubis prüft, ob die Anfrage durch darf.
Erst danach erreicht sie deine eigentliche Website oder Anwendung.
Für Projekte mit eigener Serverkontrolle kann das ein spannender Baustein sein, besonders wenn es nicht nur um Formularspam geht, sondern um Scraping, AI-Crawler und viele automatisierte Seitenaufrufe. Du solltest dann aber bewusst testen, welche Bots du blockierst und welche du erlauben willst. Selbst das Anubis-Projekt weist darauf hin, dass die Lösung auch „gute“ Bots wie Archivierungsdienste beeinträchtigen kann, wenn du sie nicht passend erlaubst.
Was ist dann besser für Shared Hosting?
Wenn du auf Shared Hosting bleibst und gezielt Formulare schützen möchtest, sind klassische formularnahe Lösungen meist sinnvoller. Damit meinen wir nicht zwangsläufig Google reCAPTCHA. Es gibt inzwischen einige Alternativen, die datenschutzfreundlicher und transparenter arbeiten.
ALTCHA
ALTCHA ist ein Open-Source-CAPTCHA, das mit Proof-of-Work arbeitet. Der Browser löst dabei im Hintergrund eine kleine kryptografische Aufgabe. Für echte Besucher soll das möglichst unauffällig bleiben. Dein Server prüft anschließend, ob die Aufgabe korrekt gelöst wurde. Der Vorteil: Es braucht keine Bildrätsel, keine Google-Abfrage und keinen Third-Party-Trackingdienst. Für PHP-Projekte ist ALTCHA besonders interessant, weil es Server-Bibliotheken und Beispiele für die Verifikation gibt.
Für klassisches Webhosting ist das näher an dem, was man in der Praxis braucht: ein Widget im Formular plus eine serverseitige Prüfung in PHP, bevor die Nachricht verschickt oder gespeichert wird.
Cap
Cap verfolgt ebenfalls einen Open-Source- und Self-Hosting-Ansatz. Es kombiniert Proof-of-Work mit weiteren Browserprüfungen und wirbt damit, ohne Google, ohne Telemetrie und ohne visuelle Rätsel auszukommen. Allerdings braucht Cap in der Self-Hosted-Variante ebenfalls eine eigene Serverkomponente. Für reines Shared Hosting kann das je nach Setup also wieder zu viel sein. Wenn du aber irgendwo einen kleinen separaten Dienst betreiben kannst, kann Cap interessant werden.
FriendlyCaptcha
FriendlyCaptcha ist eine bekannte Alternative zu reCAPTCHA und wird häufig genannt, wenn Datenschutz, Barrierearmut und weniger Nutzerfrust wichtig sind. Je nach Einsatzmodell nutzt du dabei allerdings wieder einen externen Dienst. Das kann völlig in Ordnung sein, sollte aber bewusst geprüft und in der Datenschutzerklärung sauber beschrieben werden.
Und Matomo?
Kommentare erwähnten auch Matomo als Alternative zu Google Analytics. Das passt gut zur Grundfrage: Welche externen Dienste muss ich auf meiner Website wirklich einbinden?
Bei Formularschutz und Webanalyse gilt dasselbe Prinzip: Je weniger personenbezogene Daten an Dritte fließen, desto einfacher wird oft die datenschutzfreundliche Umsetzung. Matomo kann selbst gehostet werden und ist deshalb für viele Website-Betreiber eine attraktive Alternative zu externen Trackingdiensten. Trotzdem bleibt auch hier wichtig: datensparsam konfigurieren, IP-Anonymisierung nutzen, Cookies bewusst einsetzen oder vermeiden und die Datenschutzhinweise aktuell halten.
Empfehlung für die Praxis
Wenn du ein Kontaktformular, Kommentarformular oder Login auf Shared Hosting absichern möchtest, würden wir pragmatisch so vorgehen:
Erst einfache Maßnahmen prüfen: Honeypot-Feld, serverseitige Zeitprüfung, Rate-Limits im Formularskript, Plausibilitätsprüfung der Eingaben und saubere Validierung.
Dann formularnahes CAPTCHA ergänzen: Zum Beispiel ALTCHA, FriendlyCaptcha oder eine vergleichbare Lösung, die zu deinem Datenschutzanspruch passt.
Bei starkem Missbrauch stärker absichern: Wenn Bots nicht nur Formulare, sondern die ganze Website belasten, lohnt sich der Blick auf serverseitige Schutzmechanismen, Firewalls, Reverse Proxies oder eine eigene Serverumgebung.
Anubis für passende Umgebungen testen: Wenn du einen VPS, Root-Server oder eine Container-/Proxy-Umgebung kontrollierst, kann Anubis ein sinnvoller Baustein gegen aggressive Crawler sein.
Mini-Beispiel: Was auf Shared Hosting geht
Auf klassischem PHP-Webspace kannst du ein Formular zum Beispiel so absichern:
Ein zusätzlicher unsichtbarer Honeypot bleibt für Menschen leer, wird aber von einfachen Bots ausgefüllt.
Ein Zeitstempel verhindert, dass ein Formular nach 0,2 Sekunden automatisiert abgeschickt wird.
Eine serverseitige Prüfung verwirft Nachrichten mit auffälligen Mustern, zu vielen Links oder fehlenden Pflichtfeldern.
Ein Proof-of-Work-CAPTCHA wie ALTCHA ergänzt diese Prüfung, ohne dass Google eingebunden werden muss.
Das ist weniger spektakulär als eine Web AI Firewall, passt aber sehr gut zu vielen kleinen Websites, Vereinsseiten, Freelancer-Projekten und Unternehmensseiten auf Shared Hosting.
Fazit: Anubis ist spannend, aber nicht das Formular-CAPTCHA für jeden Webspace
Anubis ist ein interessantes Open-Source-Werkzeug für Website-Betreiber, die aggressiven automatisierten Traffic schon vor der Anwendung ausbremsen möchten. Es ist aber kein Drop-in-Ersatz für reCAPTCHA im Kontaktformular.
Für Shared Hosting gilt deshalb: Wenn du nur dein Formular schützen willst, schaue dir lieber ALTCHA, FriendlyCaptcha oder andere formularnahe Lösungen an. Wenn du dagegen eine eigene Server- oder Proxy-Umgebung betreibst und Scraper deine Website stark belasten, lohnt sich ein genauer Blick auf Anubis.
Und ja: Der Hinweis aus dem Kommentar war absolut berechtigt. Google reCAPTCHA ist nicht alternativlos. Gerade bei datenschutzbewussten Webprojekten lohnt es sich, genauer hinzuschauen, welche Dienste man einbindet, welche Daten wohin fließen und welche Lösung wirklich zum eigenen Hosting-Setup passt.
Kann ich Anubis auf normalem Shared Hosting für mein Kontaktformular nutzen?
In der Regel nicht direkt. Anubis arbeitet nicht wie ein klassisches CAPTCHA im Formular, sondern als Filter vor der eigentlichen Website oder Anwendung. Dafür brauchst du Zugriff auf Reverse Proxy, Webserver-Konfiguration, Container oder eine vergleichbare Serverumgebung. Auf klassischem Shared Hosting ist diese Ebene normalerweise nicht verfügbar.
Warum ist Anubis kein Ersatz für Google reCAPTCHA im Formular?
Google reCAPTCHA, ALTCHA oder FriendlyCaptcha werden direkt in ein Formular eingebunden und prüfen den Besucher beim Absenden. Anubis setzt früher an: Es prüft HTTP-Anfragen, bevor sie deine Website oder Anwendung erreichen. Das ist eher ein Schutz gegen Scraper, AI-Crawler und automatisierten Traffic auf Website-Ebene, nicht speziell ein Formular-Widget.
Welche Alternativen eignen sich besser, um ein Kontaktformular zu schützen?
Für Shared Hosting sind formularnahe Lösungen meist praktischer. Dazu gehören Honeypot-Felder, serverseitige Zeitprüfungen, Eingabevalidierung, Rate-Limits im Formularskript und CAPTCHAs wie ALTCHA oder FriendlyCaptcha. Diese Maßnahmen lassen sich oft direkt in PHP-Formulare oder CMS-Plugins integrieren.
Ist ALTCHA datenschutzfreundlicher als Google reCAPTCHA?
ALTCHA kann datenschutzfreundlicher sein, weil es als Open-Source-Lösung ohne Google-Dienst und ohne klassische Bildrätsel auskommt. Es nutzt Proof-of-Work: Der Browser löst im Hintergrund eine kleine Aufgabe, die der Server anschließend prüft. Trotzdem solltest du immer prüfen, wie du die Lösung konkret einbindest und welche Daten dabei verarbeitet werden.
Wann ist Anubis trotzdem sinnvoll?
Anubis kann sinnvoll sein, wenn du eine eigene Server- oder Proxy-Umgebung kontrollierst, etwa einen VPS, Root-Server oder ein Container-Setup. Dann kannst du Anubis vor deine Website schalten und automatisierte Zugriffe bereits vor der Anwendung ausbremsen. Besonders interessant ist das, wenn nicht nur ein Formular betroffen ist, sondern Scraper oder AI-Crawler größere Teile deiner Website belasten.
Warum digitale Souveränität, GEO und das „Small Web“ wichtiger sind als je zuvor
Über das Ende der passiven Klick-Ökonomie, die Mechanismen von Generative Engine Optimization und den unersetzlichen Wert eines eigenen digitalen Zuhauses.
Wer heute das digitale Ökosystem beobachtet, erlebt ein Paradoxon: Nie zuvor war die Menschheit vernetzter, nie wurden mehr Informationen in Echtzeit verarbeitet – und doch stellen sich Freelancer, Agenturen, mittelständische Unternehmen und Handwerksbetriebe gleichermaßen eine fundamentale, fast existenzielle Frage:
„Lohnt sich der Aufwand für eine eigene Website im Jahr 2026 überhaupt noch?“
Die Zweifel sind berechtigt. Jahrelang funktionierte das Web nach einer einfachen Vereinbarung: Wir stellen wertvolle, strukturierte Inhalte bereit; Suchmaschinen crawlen sie, listen sie auf und schicken uns im Gegenzug qualifizierte Besucher.
Dieser Vertrag wurde einseitig gekündigt.
Suchmaschinen leiten immer weniger Traffic weiter. Google beantwortet komplexe Fragen direkt über AI Overviews. Konversationssysteme wie ChatGPT, Perplexity, Gemini und Claude liefern konsumfertige Antworten, ohne dass der Nutzer jemals eine Quellseite aufrufen muss. Was an menschlicher Aufmerksamkeit übrig bleibt, wird in den Walled Gardens von LinkedIn, Reddit, YouTube oder TikTok absorbiert.
Warum also noch Zeit, Budget und Herzblut in Webspace, DNS-Routing, Design-Systeme und Performance-Optimierung stecken? Können wir die eigene Domain nicht einfach abhaken und unsere Präsenz komplett auf fremde Plattformen verlagern?
Die Antwort lautet: Auf keinen Fall. Wer seine eigene Website jetzt aufgibt, gibt die Kontrolle über sein digitales Schicksal ab. Doch um die Website im Jahr 2026 richtig zu betreiben, müssen wir ihre Rolle radikal neu definieren.
1. Die Anatomie der Zero-Click-Ära: Was die Zahlen verraten
Das Gefühl, dass organische Klicks schwinden, ist keine subjektive Wahrnehmung, sondern ein empirisch belegter Strukturwandel.
59,7 % Zero-Click-Suchen in Europa
Eine groß angelegte Untersuchung von Rand Fishkin (SparkToro) in Kooperation mit dem Datenaggregations-Spezialisten Datos analysierte das Klickverhalten von Millionen Suchanfragen in den USA und der EU. Das Ergebnis:
In der Europäischen Union enden 59,7 % aller Google-Suchen ohne einen einzigen Klick auf das Open Web.
Auf 1.000 Suchanfragen in der EU entfallen lediglich 374 Klicks, die tatsächlich auf unabhängigen Webseiten landen. Der Rest verbleibt innerhalb der Google-eigenen Infrastruktur (YouTube, Maps, Google Flights) oder wird direkt auf der Suchergebnisseite befriedigt.
Der Gartner-Knick: -25 % Suchmaschinen-Volumen
Bereits 2024 prognostizierte das Analystenhaus Gartner, dass das traditionelle Suchmaschinen-Volumen bis 2026 um 25 Prozent einbrechen wird. Der Grund: Nutzer migrieren von klassischen Suchmasken hin zu dialogbasierten KI-Assistenten.
Wenn die Suchmaschine nicht mehr als Wegweiser fungiert, sondern als Antwortmaschine (Answer Engine), verliert das klassische SEO-Modell („Ranking auf Platz 1 = Klick-Garantie“) seine monopolare Hebelwirkung.
2. Generative Engine Optimization (GEO): Die Website als Wahrheitsquelle für LLMs
Bedeutet dieser Traffic-Rückgang, dass Websites für KI-Systeme überflüssig sind? Das exakte Gegenteil ist der Fall.
Große Sprachmodelle (LLMs) sind keine magischen Wissensspeicher. Sie greifen im Rahmen von Retrieval-Augmented Generation (RAG) und Web-Grounding kontinuierlich auf den Live-Index des Internets zu.
Hier liegt die fundamentale Abhängigkeit der KI:
Wenn ein Unternehmen keine saubere, strukturierte und aktuelle Website besitzt, passiert eines von zwei Dingen:
Das Sprachmodell greift auf veraltete Drittquellen, Forenbeiträge oder zufällige Webfragmente zurück.
Das Modell halluziniert – es erfindet Leistungen, Preise oder Kontaktdaten.
Die wissenschaftliche Bestätigung: Die Princeton-GEO-Studie
Eine Pionierarbeit auf diesem Gebiet lieferte das Forscherteam um Pranjal Aggarwal, Vishvak Murahari und Karthik Narasimhan (Princeton University, Georgia Tech, Allen Institute for AI, ACM KDD 2024 / arXiv:2311.09735).
Unter dem Titel „GEO: Generative Engine Optimization“ untersuchten die Wissenschaftler, mit welchen konkreten Optimierungsstrategien Inhalte in generativen Antworten (wie Perplexity, Gemini oder Copilot) bevorzugt berücksichtigt und zitiert werden.
Die quantitativen Hebel der Studie im Überblick:
GEO-Strategie
Funktionsweise
Relative Steigerung der Zitationswahrscheinlichkeit
Cite Sources
Explizite Nennung von Primärquellen, Studien und Fachbelegen
+41 %
Statistics Addition
Untermauerung von Thesen mit harten, überprüfbaren Zahlen
Wer seine Website abschaltet oder vernachlässigt, wird in der generativen KI-Suche unsichtbar. Wer seine Website hingegen als semantisch strukturiertes Repositorium pflegt, fungiert als primärer Wissensanker für Chatbots und Agenten.
3. Die Illusion der Plattform-Reichweite: Digitale Tagelöhner vs. Eigentümer
Viele Marketer zogen in den letzten Jahren den scheinbar bequemen Schluss: „Wenn ohnehin niemand mehr klickt, veröffentliche ich gleich nativ auf LinkedIn, Instagram oder YouTube.“
Das ist eine gefährliche strategische Falle.
Rand Fishkin fand dafür eine schonungslose Formulierung:
„The web isn’t dying, but the passive distribution model is. If you don’t own your primary touchpoint, you are merely a tenant worker on someone else’s digital plantation.“
Wer sein Geschäftsmodell ausschließlich auf Social-Media-Netzwerken errichtet, operiert unter ständiger Rechts- und Reichweitenunsicherheit:
Algorithmus-Willkür: Eine winzige Anpassung der Plattform-Metriken kann über Nacht 70 % der organischen Reichweite vernichten.
Walled-Garden-Lock-in: Plattformen streben danach, Nutzer innerhalb ihrer geschlossenen Systeme zu halten. Externe Verweise werden algorithmisch abgestraft.
Fehlender Vermögenswert: Ein LinkedIn-Profil oder ein Social-Kanal lässt sich weder vererben noch unabhängig bilanzieren. Eine Domain mit sauberer Historie, Backlink-Profil und eigener Infrastruktur hingegen ist ein digitaler Vermögenswert (Digital Asset).
Vergleich: Plattform-Präsenz vs. Eigene Website
Merkmal
Plattform (Social Media / Walled Gardens)
Eigene Website (Eigene Domain)
Eigentumsstatus
❌ Mieter / Bittsteller (Abhängig von Plattformregeln)
4. Wo Vertrauen entsteht: Die Website als Conversion-Zentrum
Niemand vergibt ein Agenturmandat über 20.000 Euro, beauftragt eine Photovoltaik-Installation für 35.000 Euro oder bucht eine spezialisierte Unternehmensberatung, nur weil ein Social-Media-Post nett formuliert war.
Social-Media-Kanäle, Newsletter und KI-Snippets sind Kanäle zur Aufmerksamkeitserzeugung. Die Vertrauensbildung und der Geschäftsabschluss finden auf der eigenen Website statt.
Bevor Kunden Geld überweisen, prüfen sie:
Transparenz & Identität: Gibt es ein solides Impressum? Wer sind die handelnden Köpfe?
Tiefgang & Methodik: Werden Fallstudien mit echter Substanz präsentiert oder nur oberflächliche Buzzwords?
Professionalität: Ist die Website technisch schnell, barrierefrei und visuell ausgereift?
Die eigene Website ist der einzige digitale Ort, an dem du die Kundenreise ohne Ablenkung steuern kannst. Auf fremden Plattformen trennt deinen potenziellen Kunden nur ein Klick von der Benachrichtigung eines Konkurrenten oder dem nächsten Katzenvideo. Auf deiner Website gehört die Aufmerksamkeit ganz dir.
5. Die Gegenbewegung: „Weird & Human“ im Zeitalter des generativen Einheitsbreis
Das Web des Jahres 2026 leidet unter einer beispiellosen Flut synthetischer Beliebigkeit.
Tausende automatisierter Blogs erzeugen täglich Millionen Wörter aus immer denselben generischen Formulierungen („In der heutigen, sich schnell verändernden Welt…“). Stockfotos mit künstlicher Plastikhaut und seelenlose Marketing-Templates ersticken das Internet in Gleichförmigkeit.
Genau hier entsteht eine der größten Differenzierungschancen der letzten zwanzig Jahre: Das Prinzip „Weird & Human“.
Wenn alles synthetisch perfekt und damit austauschbar ist, wird das Unperfekte, Echte, Handgemachte und Charakterstarke zum ultimativen Qualitätsmerkmal.
Deine eigene Website ist die einzige Leinwand, auf der du diese Menschlichkeit kompromisslos ausdrücken kannst:
Eigene Tonalität: Texte mit Ecken, Kanten und einer unverkennbaren Handschrift.
Eigenwilliges Design: Abweichungen vom typischen Drei-Spalten-SaaS-Einheitslayout.
Transparente Fehlerkultur: Ehrliche Einblicke in Prozesse, Fehlschläge und handwerkliche Details.
6. Hosting-Handwerk als Fundament: Digitale Souveränität statt Cloud-Monopole
All diese strategischen Überlegungen ruhen auf einem handwerklichen Fundament, das in Zeiten abstrakter Cloud-Konzepte oft in den Hintergrund gedrängt wird: solider, verlässlicher Serverbetrieb.
Steve Jobs pflegte zu betonen, dass ein meisterhafter Schreiner für die Rückseite einer Kommode kein billiges Sperrholz verwendet – selbst wenn die Wand das Holz verdeckt. Er nimmt feinstes Furnier, weil er weiß, dass es da ist. Das ist handwerklicher Anstand.
Im Webhosting gilt exakt dasselbe Prinzip. Wir sprechen gerne von „Boring Technology“:
Infrastruktur, die so reibungslos, präzise und ausfallsicher wie ein Schweizer Uhrwerk funktioniert, dass man im Alltag keinen Gedanken daran verschwenden muss.
Das „Small Web Sanctuary“
Eine eigene Website auf eigener Infrastruktur – betrieben mit 100 % Ökostrom im Rechenzentrum in Frankfurt am Main, vollständig geschützt durch europäische Datenschutzgesetze – ist kein Nostalgieprojekt. Es ist dein digitaler Schutzraum (Small Web Sanctuary).
Es ist der Garant dafür, dass:
niemand deine Daten unkontrolliert zum Training fremder Modelle abgreift,
kein Plattformbetreiber willkürlich die Gebühren anhebt,
dein Unternehmen unabhängig von geopolitischen Entscheidungen einzelner US-Tech-Konzerne arbeitsfähig bleibt.
7. Der strategische Aktionsplan für 2026: Was jetzt zu tun ist
Aus den Erkenntnissen der Recherche und der aktuellen Marktlage ergeben sich vier konkrete Handlungsschritte für Webprofessionals:
Schritt 1: Vom Keyword-Stuffing zur semantischen Autorität
Vergiss veraltete SEO-Praktiken, die auf das wiederholte Platzieren von Suchbegriffen abzielten. Schreibe Inhalte, die präzise Fragen erschöpfend beantworten. Nutze konkrete Zahlen, verlinke Primärquellen und binde Originalzitate ein. Das macht deine Seite zur idealen Zitationsquelle für Suchmaschinen und KI-Agenten.
Schritt 2: Semantisches Markup implementieren
Mache Maschinen das Verstehen deiner Daten so leicht wie möglich. Strukturiere Entitäten (Unternehmen, Personen, Produkte, Dienstleistungen, FAQs) über sauberes Schema.org-JSON-LD-Markup. Dies dient LLM-Crawlern als direkte semantische Schnittstelle.
Schritt 3: Den Fokus von Klicks auf Markenautorität verlagern
Bewerte den Erfolg deiner Website nicht mehr primär an isolierten Besucherzahlen (Traffic Volume), sondern am Einfluss auf deine Marke (Brand Influence). Wenn ein Entscheidungsträger dich über einen KI-Bot entdeckt, anschließend deine Website besucht und eine Anfrage stellt, hat die Website ihren Dienst perfekt erfüllt – selbst wenn der traditionelle SEO-Traffic stagniert.
Schritt 4: Die eigene Home Base absichern
Setze auf Unabhängigkeit. Kontrolliere deine Domain, pflege deine Mailinglisten über RSS oder eigene Newsletter-Systeme und hoste auf verlässlicher, europäischer Infrastruktur.
Fazit: Die Website ist nicht tot – sie ist erwachsen geworden
Brauchen wir 2026 also noch eine eigene Website?
Mehr denn je.
Nicht mehr als digitaler Flyer, der passiv auf Google-Klicks wartet. Sondern als:
Schutzraum für deine unternehmerische Unabhängigkeit.
Wer heute in seine eigene Website investiert, baut kein Relikt der Vergangenheit. Er errichtet das Fundament für ein souveränes, krisenfestes und menschliches Web.
Der 1. Mai ist auch für uns bei goneo ein guter Anlass, im täglichen digitalen Hustle einmal innezuhalten: Was bedeutet Arbeit heute eigentlich noch?
Wir sehen bei unseren Kund:innen jeden Tag, dass sich Arbeit verändert. Nicht nur in den großen Schlagzeilen, sondern ganz konkret im Tagesgeschäft. Aufgaben, die früher Zeit, Routinen und oft auch Nerven gekostet haben, lassen sich heute deutlich einfacher lösen. Webseiten entstehen schneller, Inhalte werden gezielt vorbereitet, E-Mail-Prozesse laufen strukturierter. KI ist kein Selbstzweck – sie ist ein Werkzeug, das uns den Rücken freihält.
Ausführung ersetzt durch Orchestrierung
Viele unserer Kund:innen erledigen nicht einfach nur weniger Aufgaben – sie arbeiten grundlegend anders. Wer früher mühsam manuell gebaut, sortiert, angepasst und nachgebessert hat, übernimmt heute stärker die Rolle des Gestalters: steuern, prüfen, entscheiden. Die Kunst liegt nicht mehr im Abarbeiten, sondern im Überblick behalten und Lenken. Aus Ausführung wird Orchestrierung.
Mit den KI-Funktionen in easyPage– und bald auch in WordPress 7 – möchten wir dich genau dabei unterstützen. Unser neues Produkt goneo WordPress-Power übergibt dir WordPress komplett schlüsselfertig in einer optimierten Umgebung. KI-ready ab Version 7 – und schon jetzt mit passenden Plugins ausgestattet.
Webhosting als moderne Schaltzentrale
Und bei technisch versierten Nutzer:innen passiert etwas Spannendes: Hosting wird zur digitalen Schaltzentrale. Die eigene Website ist nicht mehr nur eine Visitenkarte, sondern Teil einer intelligenteren Arbeitsumgebung. Sie verbindet, strukturiert, denkt mit – und ist direkte Schnittstelle zu deinen Kund:innen oder Interessent:innen.
Doch bei all dem Wandel bleibt etwas Grundlegendes unverändert:
„KI ist ein Werkzeug. Der Mensch bleibt der Partner.“
Mensch bleiben in der digitalisierten Welt
Das ist unsere Philosophie bei goneo: Wir möchten, dass du mit den neuen Möglichkeiten experimentierst. Dass du produktiver wirst. Dass mehr Freiräume entstehen – für Ideen, kreative Entscheidungen, das, was dein Projekt besonders macht.
Gleichzeitig wissen wir, wo echte Unterstützung zählt – nämlich dort, wo es um deine Infrastruktur, deine Anliegen, deine Fragen geht. Deshalb bleibt unser Support bewusst bot-frei: Du rufst an, du sprichst mit einem Menschen. Denn persönliche Hilfe und echte Expertise sind für uns wichtiger als jede automatische Gesprächssimulation.
Jetzt günstig ins WordPress-Hosting starten
Gerade zum Tag der Arbeit ist uns wichtig: So günstig ist unser Hosting wirklich! Mit goneo WordPress-Power startest du sofort durch – ohne Setup-Stress, ohne versteckte Kosten. Klar strukturierte Preise, starke Features, echter Support – und das alles so, dass du dich auf das Wesentliche konzentrieren kannst: deine Inhalte, deine Marke, deine Ideen.
Fazit
Die digitale Arbeitswelt verändert sich – und mit ihr, wie wir arbeiten: weniger routinierte Ausführung, mehr strategische Gestaltung. Wir bei goneo möchten diesen Wandel gemeinsam mit dir gestalten: sinnvoll, praktisch und menschlich.
Wir wünschen dir einen angenehmen und inspirierenden 1. Mai!
Hast du deinen Kaffee schon auf Betriebstemperatur? Gut so, denn heute graben wir richtig tief.
Ich komme gerade aus einer – dummerweise nur mentalen – Reise aus Mumbai zurück – dem WordCamp Asia 2026 – und mein Techie-Herz macht gerade mehr Freudensprünge als ein indischer Tanzfilm aus Bollywood zeigt.
Wer mich kennt, weiß um meinen Bezug zu der geografischen Region. Wenn also technologische Innovationen von Weltformat im Jio World Convention Centre in Mumbai gezündet werden, dann ist das für mich nicht nur Business, das hat auch etwas Persönliches.
Auch wenn ich selbst nicht vor Ort war, meine Kollegen und Kolleginnen waren es.
Unsere Kolleginnen und Kollegen beim WordCamp Asia im April 2026 im Jio World Convention Centre in Mumbai.
Und weil ich das Buch „INSPIRED BY THE FEAR OF BEING AVERAGE“ von Ayra Mudessir so liebe, sage ich dir: WordPress 7.0 ist die Antwort darauf, niemals nur „Durchschnitt“ zu sein. Es ist der Sprung vom Blog-Tool zur KI-Infrastruktur.
1. Der Mumbai-Vibe: Mehr als nur Curry und Code
Die Skalierung in Mumbai war absolut mega. Wir reden hier nicht von einem kleinen Nerd-Treffen. Über 2.281 Teilnehmer haben die Hallen geflutet. Der Contributor Day allein war mit über 1.500 Leuten an über 20 Tischen so produktiv, dass man die Energie förmlich riechen konnte (und ja, das lag ein bisschen auch am Streetfood!).
Dort wurde die „Wapuulika“ gefeiert – das offizielle Maskottchen im Sari mit Vada Pav in der Hand. Ein Symbol für das moderne Indien, das die Tech-Welt gerade im Sturm erobert.
Kennzahl
WordCamp Asia 2026 Highlights
Bedeutung für WordPress
Veranstaltungsort
Jio World Convention Centre, Mumbai
Einer der modernsten Tech-Hubs weltweit
Teilnehmer
2.281 (globaler Mix)
WordPress zementiert seine globale Dominanz
Contributor Day
> 1.500 Aktive
Massive Manpower für den Core-Schub
E-Commerce Wachstum
+18,6 % in Südostasien
WooCommerce wird zur Infrastruktur Nr. 1
Zukunftsevent
WordCamp India 2027 angekündigt
Indien wird zum vierten globalen Flaggschiff
2. Der globale Check: Warum der Osten den Ton angibt
Warum verlagert WordPress seinen Fokus so krass nach Asien? Ganz einfach: Während der Markt in den USA und Europa (mit über 18,7 Mio. bzw. 1,9 Mio. Seiten) als „erwachsen“ gilt, spielt im asiatisch-pazifischen Raum die Musik der Zukunft. Hier haben wir Wachstumsraten (CAGR) von bis zu 15,1 % – das ist der absolute Wahnsinn!
Status Quo 2026
Entwickler-Power
Besonderheit
USA
~16,5-18,7 Mio. Seiten
18,3 % (Platz 1)
Fokus auf Enterprise & SaaS-Konkurrenz
Deutschland
~1,9 Mio. Seiten
6,75 % (Platz 3)
Fokus auf Stabilität & Datenschutz (GDPR)
Indien/Asien
Explosives Wachstum
12,6 % (Platz 2, steigend)
Mobile-First & Höchstes KI-Interesse
Indien führt übrigens weltweit bei den Besuchen von KI-WordPress-Plugins (11,1 Mio. Visits!). Die Leute dort „ballern“ KI-Features in ihre Workflows, während wir hier manchmal noch über das richtige Cookie-Banner diskutieren. Aber genau dieser Speed aus Asien sorgt dafür, dass WordPress für uns alle konkurrenzfähig gegenüber Wix oder Shopify bleibt.
3. WordPress 7.0: Warum die Verspätung genial ist
Eigentlich sollte Version 7.0 pünktlich zum Camp droppen. Aber die Führung hat die Reißleine gezogen. Warum? Weil die Real-Time Collaboration (RTC) – also echtes, gleichzeitiges Arbeiten wie in Google Docs – perfekt sein muss.
Das Problem: Die ursprüngliche Speicherung in der post_meta-Tabelle hat bei großen Seiten das Caching zerschossen. Die Lösung? Eine dedizierte Datenbank-Tabelle nur für die Sync-Daten. Das ist ein massiver Eingriff unter die Motorhaube, aber er sorgt dafür, dass deine Seite stabil läuft, egal wie viele Leute gleichzeitig im Backend tippen. Das ist echte technologische Exzellenz.
4. WPDrama: WordPress vs. Cloudflare (EmDash)
In Mumbai gab es nicht nur technisches Feuerwerk, sondern auch Beef am Spielfeldrand! Cloudflare hat am 1. April EmDash rausgehauen und das Ding allen Ernstes als „spirituellen Nachfolger von WordPress“ bezeichnet. Da ist Matt Mullenweg aber offenbar der Kragen geplatzt – und ich kann es verstehen! Die haben WordPress in Typescript nachgebaut – Vibecoding macht’s eben möglich.
Demokratisierung vs. Vendor-Lock-in: Während WordPress überall läuft – vom Raspberry Pi bis AWS – dient EmDash laut Matt primär dazu, mehr Cloudflare-Services zu verkaufen. Echte Freiheit bedeutet, dass dein Code unabhängig vom Hosting funktioniert!
Plugin-Sicherheit: EmDash setzt auf „Sandboxing“. Matt kritisiert das scharf. Er sagt: Dass Plugins fast alles an WordPress ändern können, ist ein Feature, kein Bug! Die Sicherheitsprobleme will er in den nächsten 18 Monaten lieber durch KI-gestützte Audits lösen.
Die Ansage: Emotional wurde es auch. In einer Reaktion, die er später als „zu scharf“ bezeichnete, feuerte er Richtung Cloudflare: „Keep WordPress out of your mouth“, wenn ihr den Geist von Open Source nicht versteht! Geil, oder? Da brennt noch Leidenschaft für die Sache!
5. Der „Agentic Web“ Shift: Deine Seite bekommt ein Gehirn
Jetzt wird’s richtig geekig. Mit der Abilities API bekommt WordPress ein Gehirn. WordPress ist nicht mehr nur ein Speicher für Texte, sondern ein System, das seine eigenen Fähigkeiten kennt. Über das Model Context Protocol (MCP) können KI-Agenten deine Seite verstehen.
Stell dir vor, du sagst deiner KI: „Optimiere alle Bilder und schreib SEO-Exzerpte für die Posts der letzten Woche.“ WordPress liefert die Infrastruktur (Abilities), und die KI führt es sicher aus, ohne dass du 20 Plugins brauchst.
Feature
Technischer Kern
Dein Nutzen
WP AI Client
Provider-agnostische PHP-Library
Ein Standard für OpenAI, Gemini & Co.
Abilities API
Maschinenlesbares Verzeichnis
KIs können Aufgaben autonom ausführen
DataViews
React-basiertes Admin-Interface
Weg mit alten Tabellen, her mit App-Feeling
Interactivity API
Native JS-Standardisierung
Interaktive Elemente ohne Plugin-Müll
6. JavaScript & Node.js: Der neue Standard
Mit Informatik-Augen sag ich’s euch: Die Zeiten von „nur ein bisschen PHP“ sind vorbei. WordPress 7.0 setzt voll auf den modernen JS-Stack. Der Editor ist jetzt immer in einem Iframe gekapselt – das schützt dein Design vor CSS-Konflikten durch Plugins (endlich!).
Mit React 19 unter der Haube und einem Build-Workflow, der massiv auf Node.js und wp-scripts setzt, wird WordPress zur echten Web-App-Plattform. Wir nutzen jetzt die gleichen Patterns wie in großen Enterprise-Apps. Das ist kein „Basten“ mehr, das ist Software-Engineering.
Expertinnen-Check: Bist du bereit für 7.0?
Damit du nicht im „Average“-Sumpf stecken bleibst, hier meine Checkliste für dich:
PHP-Version: WordPress 7.0 braucht mindestens PHP 7.4, aber wer schlau ist, geht direkt auf 8.2 oder 8.3. (7.4 gibt es bei goneo sowieso nicht mehr). Das macht den Code schneller und besser lesbar für KIs.
Staging ist Pflicht: Wegen der neuen RTC-Datenbank-Tabellen solltest du niemals direkt „live“ updaten. Teste es erst in einer sicheren Umgebung.
Mobile-First: 95,9 % der Leute gehen übers Handy ins Netz. Nutze die neuen responsive Controls von 7.0, um Blöcke gezielt für Mobile ein- oder auszublenden.
Data Ownership: In Zeiten von „moody landlords“ (Social Media Algorithmen) ist deine WordPress-Instanz deine einzige Versicherung. WordPress 7.0 macht diese Homebase stärker als je zuvor.
Fazit: WordPress ist die Zukunft
Mumbai hat gezeigt: WordPress ruht sich nicht aus. Wir bewegen uns weg vom statischen CMS hin zu einem kollaborativen, KI-gesteuerten Ökosystem. Der Speed aus Asien kombiniert mit unserer europäischen Liebe für Qualität macht WordPress unschlagbar.
Also, geh in dein goneo-Kundencenter, check deine PHP-Version und mach dich bereit. Die Zukunft ist da – und sie trägt einen Sari und schreibt verdammt guten Code! 😉
Bleib kreativ, bleib mutig und vor allem: Sei niemals durchschnittlich!
Du hast Fragen?
Warum wurde WordPress 7.0 eigentlich verschoben?
Das Team legt Wert auf extreme Stabilität statt auf schnelle PR-Erfolge. Vor allem die neue Datenbank-Struktur für die Echtzeit-Kollaboration (RTC) braucht diesen Feinschliff, damit die Performance auch bei hoher Last nicht einknickt.
Was bringt mir die „Abilities API“ im Alltag?
Stell sie dir wie eine Bedienungsanleitung für KI-Agenten vor. Sie erlaubt es Tools wie Claude oder ChatGPT, genau zu verstehen, was deine Website kann (z. B. „Erstelle eine Zusammenfassung“), und diese Aufgaben sicher auszuführen.
Muss ich jetzt sofort meine PHP-Version updaten?
Für WordPress 7.0 ist PHP 7.4 das absolute Minimum, was aber bei goneo nicht mehr zur Verfügung steht. Aber mal ehrlich: Um die neuen Features wirklich zu rocken, solltest du direkt auf PHP 8.2, 8.3 oder höher gehen.
Was hat der indische Markt mit meiner deutschen Website zu tun?
In Asien entstehen gerade die Mobile-First-Trends von morgen. Durch den massiven Fokus von WordPress auf diesen Wachstumsmarkt landen Performance-Optimierungen für mobile Geräte direkt im Core – wovon du bei deinen Core Web Vitals massiv profitierst.
Ist WordPress 7.0 sicher genug für das „agentische Web“?
Ja, denn Sicherheit wird hier durch KI-gestützte Audits und eine klare Rollenverteilung in der Abilities API neu definiert, anstatt Funktionen einfach nur wegzusperren.
PHP 2026: Warum das „Arbeitstier des Webs“ gerade sein bestes Jahr erlebt
„PHP ist tot.“ Wie oft haben wir diesen Satz in den letzten zehn Jahren gehört? Doch wer im März 2026 einen Blick auf die harten Fakten wirft, erkennt schnell: PHP ist nicht nur am Leben, es ist fitter, schneller und moderner als je zuvor. Mit einem Marktanteil von stolzen 71,7 % bleibt es die unangefochtene Nummer eins der serverseitigen Sprachen.
Für uns WordPress-Nutzer und DIY-Websitebetreiber ist das eine großartige Nachricht. Während die JavaScript-Welt oft von „Hype-Zyklen“ und komplexen Toolchains geplagt wird, hat sich PHP zu einem hochperformanten Enterprise-Werkzeug entwickelt, das Stabilität mit modernster Syntax verbindet.
Die Evolution: PHP 8.5 ist „Alien-Technologie“ für alte Hasen
Wer zuletzt mit PHP 5.6 gearbeitet hat, würde den Code von heute kaum wiedererkennen. Es fühlt sich für Veteranen fast wie „Alien-Technologie“ an – im positiven Sinne. Mit den neuesten Releases sind Features eingezogen, die das Entwickeln flüssiger machen:
Der Pipe-Operator (|>) in PHP 8.5: Endlich können wir Funktionen elegant verketten, statt sie ineinander zu verschachteln.
Property Hooks (PHP 8.4): Schluss mit dem endlosen Schreiben von Gettern und Settern. Wir können Logik jetzt direkt an die Eigenschaften einer Klasse binden.
Persistent cURL Handles: Diese sorgen für einen massiven Performance-Boost bei API-Abfragen, da Verbindungen über Requests hinweg im Speicher bleiben.
PHP vs. JavaScript: Der architektonische Deep Dive
Oft werden wir gefragt: „Sollte ich für mein nächstes Projekt nicht lieber auf Node.js oder Next.js setzen?“ Die Antwort liegt in der Softwarearchitektur.
Shared-Nothing vs. Event-Loop
PHP nutzt klassischerweise die „Shared-Nothing“-Architektur. Das bedeutet: Jeder Request startet bei Null, verarbeitet die Daten und stirbt danach. Das klingt ineffizient, ist aber ein genialer Sicherheitsanker. Ein Fehler in einem Nutzer-Request kann niemals den gesamten Server lahmlegen.
JavaScript (Node.js) hingegen nutzt einen persistenten Event-Loop. Das ist fantastisch für Echtzeit-Anwendungen wie Chats, birgt aber für DIY-Betreiber Risiken: Ein Memory Leak (ein Speicherfehler) kann dazu führen, dass die gesamte Applikation über Zeit immer langsamer wird oder abstürzt. PHP ist hier „fehlertoleranter“ und wartungsärmer.
Kosten und Hosting: Der DIY-Faktor
Für Websitebetreiber, die auf das Budget achten, bleibt PHP der König. PHP-Hosting ist universell verfügbar, günstig und extrem einfach zu skalieren. Node.js-Projekte erfordern oft spezialisierte Umgebungen und teurere Entwickler-Stunden, da die Komplexität der asynchronen Programmierung (Callbacks, Promises) höher ist.
Ein Realitätscheck: Das Fallbeispiel Friendica
Dass PHP modern ist, bedeutet nicht, dass man jedes Projekt auf kleinstem Raum betreiben kann. Die dezentrale Web-App Friendica (ein soziales Netzwerk auf LAMP-Basis) zeigte mir die Grenzen auf. Friendica benötigt für die Kommunikation mit tausenden anderen Servern im Fediverse enorm viel RAM – oft sind mindestens 2 GB erforderlich. Und RAM ist heute knapp und teuer.
Auf einem günstigen Shared-Hosting-Paket mit nur 1 GB RAM gerät Friendica ins Straucheln. Die Hintergrund-Prozesse (Worker) erzeugen so viel Kommunikations-Overhead, dass es zu „Too many MySQL connections“-Fehlern kommen kann. Das lehrt uns: Wenn deine PHP-App extrem interaktiv ist und ständig im Hintergrund funkt, investiere in einen VPS (Virtual Private Server), statt am Hosting zu sparen. Ähnliches gilt auch für die beliebte WebApp Nextcloud, besonders wenn es um die Interaktionen geht wie Sharing, Kommentierung von Dateien etc.
Frameworks und E-Commerce: Die Giganten von 2026
In der PHP-Welt haben sich klare Favoriten herauskristallisiert:
Laravel (64 % Marktanteil): Das „Framework für Developer-Happiness“. Es macht den Bau komplexer Web-Apps so schnell wie kaum ein anderes System.
Symfony: Das stabile Fundament für Enterprise-Lösungen.
Doppar: Der neue Disruptor. Mit nativem WebSocket-Support bringt es Echtzeit-Fähigkeiten direkt in die PHP-Welt, ohne dass man einen separaten Node.js-Server benötigt.
Im E-Commerce bleibt PHP ungeschlagen. WooCommerce treibt weiterhin rund 37 % aller Online-Shops weltweit an. Wer mehr Power braucht, greift zu Magento für den Enterprise-Bereich oder zum DACH-Innovationsführer Shopware 6, der mit seiner API-First-Architektur neue Maßstäbe setzt.
PHP und KI: Das perfekte Gespann
Entgegen der Meinung, KI gehöre nur der Python-Welt, hat sich PHP 2026 als idealer KI-Orchestrator etabliert. Während Python die Modelle trainiert, ist PHP die Sprache, die die KI-APIs wie ChatGPT von OpenAI oder Claude von Anthropic in echte Geschäftsprozesse integriert, Nutzerdaten verwaltet und die Logik steuert. Mit Bibliotheken wie Rubix ML lassen sich sogar Machine-Learning-Modelle direkt in PHP ausführen.
PHP in der Rolle des „Orchestrators“
Vom Modell zum System: Die KI-Entwicklung hat sich massiv von der reinen Modelloptimierung (Genauigkeit, Parameter) hin zum Aufbau ganzer KI-Systeme verschoben. Ein solches System benötigt Datenbanken, Authentifizierungsschichten, Logging und komplexe Geschäftsregeln – allesamt Kernkompetenzen von PHP-Backends – schau dir mal LLPhant an.
PHP als Gatekeeper für KI-Agenten: Moderne KI-Anwendungen agieren zunehmend als autonome Agenten. PHP-Backends fungieren hierbei als Sicherheitsinstanz, die definiert, welche internen APIs ein Agent aufrufen darf, und die notwendigen Beschränkungen und Validierungen erzwingt.
Kontext-Management: KI-Modelle sind an sich zustandslos. PHP übernimmt die Verwaltung des „Kontexts“ (Sessions, Benutzerhistorie, Metadaten), um sicherzustellen, dass die Antworten der KI für den jeweiligen Nutzer relevant und konsistent bleiben.
Integration in bestehende Infrastruktur: Da PHP weiterhin rund 71,7 % des Webs antreibt, befinden sich dort die Nutzerdaten und Geschäftsprozesse (z. B. in WordPress, Laravel oder E-Commerce-Systemen wie Magento). Es ist effizienter, die KI über REST-APIs oder Webhooks direkt in diese bestehenden PHP-Umgebungen einzubinden, als die gesamte Infrastruktur in Python neu aufzubauen.
Wirtschaftlichkeit und Geschwindigkeit: PHP ermöglicht extrem schnelle Entwicklungszyklen für MVPs (Minimum Viable Products). Während Python die schwere Rechenarbeit für das Modell leistet, sorgt PHP dafür, dass diese Leistung in einer stabilen, skalierbaren und kostengünstigen Webumgebung beim Endnutzer ankommt.
Python liefert die „Rohintelligenz“, aber PHP kann das das Gehäuse und die Steuerung bauen, damit diese Intelligenz in einem geschäftlichen Kontext sicher und nutzbringend arbeiten kann.
Warum es gut ist, dass du weiter auf PHP setzt
PHP ist 2026 keine „Legacy-Sprache“. Es ist ein stabiles, hochperformantes und wirtschaftlich unschlagbares Werkzeug. Für DIY-Websitebetreiber bietet es die perfekte Balance:
Geringe Einstiegshürde bei gleichzeitigem Enterprise-Potenzial.
Massives Ökosystem an Plugins und Themes (WordPress!).
Moderne Syntax, die Spaß macht und Code-Leichen vermeidet.
Egal, ob du einen Blog startest, einen Shop mit WooCommerce aufbaust oder eine komplexe API entwickelst: PHP gibt dir die Sicherheit, dass deine Technologie auch in zehn Jahren noch da ist.
Bist du bereit für das Upgrade? Switche im goneo-Kundencenter von PHP 8.5 und erlebe den Unterschied!
Hey, du WordPress-Fan! Ich sitze gerade bei einer Tasse Kaffee in der Mindener Altstadt und schaue aus dem Fenster auf die Weser. Beim Gedanken an WordPress: Fragst dich auch, was die Zukunft für dein Lieblings-CMS bringt? WordPress 7 kommt. Schnall dich an! Was ich heute habe, ist kein Bericht über ein simples WordPress-Update, ich halte die 7 für eine echte Zäsur nach langer Zeit.
Ok, WordPress 7.0 wurde verschoben. Erst hieß es: 9. April 2026. Nun soll es am 20.Mai so weit sein.
Der Release von WordPress 7.0 verschiebt sich, um die Stabilität der neuen Echtzeit-Kollaboration und eine performante Systemarchitektur zu gewährleisten. Das Entwicklerteam priorisiert die Fehlerbereinigung bestehender Funktionen gegenüber neuen Features, um einen reibungslosen Übergang in die nächste Phase der Gutenberg-Evolution sicherzustellen.
Es ist viel mehr als nur ein bisschen neuer Code – übertreibe ich, wenn ich schreibe, es ist das neue Betriebssystem für das moderne Web werden kann? Lies und urteile selbst.
Ich denke, wir verabschieden uns von der Zeit, in der WordPress nur ein Content-Management-Werkzeug war. Jetzt wird es zur orchestralen Plattform für digitale Design-Systeme und künstliche Intelligenz.
Warum 7.0 eine Ansage ist, mit der man rechnen muss
Vielleicht hast du gemerkt, dass es 2025 etwas ruhiger zuging? Das war Absicht! Anstatt drei Releases durchzupeitschen, wurde das Tempo gedrosselt, um technische Schulden abzubauen und ein Fundament zu gießen, das stabil genug für die nächste Dekade ist.
Das Ziel war es, die „Angst vor dem Durchschnitt“ zu besiegen -(ein Mindset, das ich aus dem Buch von Ayra Mudessir liebe; Link zu Youtube) – und Funktionen zu bringen, die früher nur teuren Enterprise-Systemen vorbehalten waren.
Der Fahrplan der Evolution (aktualisiert)
Die Veröffentlichung sollte zum WordCamp Asia erfolgen, daraus wurde nichts.
Meilenstein
Datum
Fokus
Release Candidate 3
8.Mai 2026
fungiert technisch als neue Beta 1
Release Candidate 4
14.Mai 2026
fungiert als neuer RC 1
Code-Freeze
19.Mai 2026
„Dry Run“
Finaler Release
9. April 2026
Offizielle Veröffentlichung
Aus dem Maschinenraum: Wir produzieren in Minden und Frankfurt die Power für das Web mit WordPress
Um diese geballte Power sicher zu verarbeiten, mussten die Mindestanforderungen steigen. Das ist eine Ansage an alle Profis auch hier hier in Ostwestfalen: Wer wettbewerbsfähig bleiben will, muss sein Stack aktuell halten! Bei goneo tun wir das. PHP 8.4 ist bereit, 8.5 schon in der Erprobung in unseren Rechenzentren in Frankfurt.
PHP-Power: Die neue Basis ist PHP 7.4, was moderne Syntax und Typisierung im Kern ermöglicht. Aber mal ehrlich: Für eine wirklich geniale Performance und Sicherheit solltest du auf PHP 8.3 oder 4 setzen. Das reagiert nicht nur schneller, sondern ist auch weniger anfällig für Speicherengpässe.
Die Iframe-Revolution: Ein technisches Highlight ist das vollständige Iframing des Editors. Das bedeutet, der Editor wird in einer sauberen Sandbox geladen. CSS-Stile von Plugins leaken nicht mehr in dein Bearbeitungsfenster. Endlich Schluss mit Layout-Differenzen zwischen Backend und Live-Seite – ein mega Fortschritt für deine Design-Präzision!
Phase 3: Gemeinsam statt einsam (Kollaboration)
Hier wird es ein bisschen emotional (nur ein bisschen). WordPress transformiert sich von einem System für Einzelkämpfer zu einer dynamischen Umgebung für Teams.
Real-Time Co-Editing: Bye-bye Post-Locking!
Kennst du den Frust, wenn ein Beitrag gesperrt ist, weil jemand anderes ihn gerade offen hat? Das ist Geschichte! In WordPress 7.0 können mehrere Leute gleichzeitig am selben Dokument arbeiten. Du siehst die Cursor deiner Kollegen in Echtzeit flitzen. Das System nutzt dafür hocheffizientes HTTP Polling, damit es wirklich überall – auch auf Shared-Hosting – reibungslos läuft.
Notes & Feedback
Für die asynchrone Arbeit gibt es jetzt „Notes“. Du kannst Kommentare direkt an Blöcke oder Textstellen heften und Kollegen per @-Erwähnung benachrichtigen. Das ist ein absolutes Killer-Feature für Agenturen, weil das Feedback genau dort landet, wo die Arbeit passiert.
Feature
Nutzen für den Workflow
Technischer Mechanismus
Co-Editing
Gleichzeitiges Schreiben ohne Datenverlust
HTTP Polling Sync
Inline Notes
Gezieltes Feedback an Elementen
Kommentar-Registry
Cursor Tracking
Sichtbarkeit der Kollegen-Aktivität
Live-Presence-API
Spotlight Mode
Fokus auf ein einzelnes Element
Editor-Overlay-System
Design-Systeme: Du bist der Kurator
Wir verlassen das Zeitalter, in dem wir nur „Seiten“ bauen. WordPress 7.0 setzt auf die Atomic-Design-Methodik. Du gestaltest keine Seiten mehr, du kuratierst Atome, Moleküle und Organismen.
theme.json & Design-Tokens: Du steuerst Hierarchien global. Einmal definierte Tokens für Farben oder Abstände ziehen sich durch das gesamte Projekt. Das verhindert Design-Wildwuchs und sorgt für eine beispiellose Wartbarkeit.
Dynamische Sichtbarkeit: Du kannst jetzt direkt in der block.json festlegen, ob ein Element nur auf dem Desktop, Tablet oder Smartphone angezeigt wird. Hochgradig optimierte mobile Erfahrungen – genial!
DataViews: Die neue Admin-Oberfläche
Sag „Tschüss“ zu den statischen PHP-Tabellen von 2005! Die neuen DataViews sind eine moderne, JavaScript-basierte Schnittstelle, die sich wie eine App anfühlt. Du kannst deine Inhalte in Grids, Tabellen oder Listen visualisieren. Filter und Sortierungen passieren unmittelbar ohne Reload. Das Beste: Das System merkt sich deine bevorzugten Ansichten! Achtung für Entwickler: Plugins, die die alten Listen-Tabellen modifiziert haben, brauchen dringend ein Update, sonst gibt es Brüche in der User-Experience.
KI-Integration: Dein CMS wird zum Genie
Das ist die wohl zukunftsträchtigste Neuerung: Die Abilities API und der native KI-Client. WordPress ist hier „Provider-agnostisch“ – es liefert keine eigenen Modelle mit, sondern stellt die standardisierte Schnittstelle bereit.
Die Abilities API erlaubt es Plugins, ihre Funktionen maschinenlesbar zu registrieren. Eine KI kann so entdecken, was deine Website alles kann, und Aufgaben autonom ausführen. Stell dir vor, du sagst deinem Assistenten: „Erstelle eine Zusammenfassung der letzten fünf Beiträge und generiere passende Alt-Texte“. Die KI findet die passenden „Abilities“, prüft die Berechtigungen über den permission_callback und legt los.
Lokale KI & MCP: Datensouveränität pur – Erfahre mehr:
🤖 KI & Infrastruktur (MCP & Abilities API)
Essential Addons – MCP for WordPress: AI Breakthrough You Need to Adopt. Dieser Guide erklärt im Detail, warum MCP der entscheidende Durchbruch ist, um WordPress in ein aktives, intelligentes System zu verwandeln.
Unter der Haube nutzt WordPress 7.0 jetzt die Rechenpower deines Endgeräts. Dank WASM findet aufwendige Medienverarbeitung nun direkt in deinem Browser statt.
Bildkomprimierung & Video-Transcoding: Früher musste der Server alles berechnen. Jetzt erledigt das dein Browser via wasm-vips und ffmpeg.wasm. Das reduziert die Serverlast um ca. 80 %!
Saliency Detection: Ein mega Feature! Kleine KI-Modelle im Browser erkennen beim Zuschneiden automatisch wichtige Bildbereiche (wie Gesichter). Nie wieder abgeschnittene Köpfe in automatisierten Galerien!
🎨 Design & Kollaboration -lies weiter:
InstaWP – WordPress 7.0 Features: Ein super Überblick über die DataViews und das neue Kollaborations-Modell (Phase 3).
WordPress 7.0 ist kein einfaches Blog-Tool mehr. Es ist das Fundament für ein souveränes, intelligentes Webdesign. Ob du nun Blogger bist und von der Kollaboration profitierst , als Freelancer mit der Block Bindings API komplexe Backends baust oder als Agentur die Sicherheit von PHP 8.4 schätzt – diese Version ist eine Befreiung.
Bevor du den Sprung wagst: Plane sorgfältig! Teste alles in einer Staging-Umgebung, geh erst auf 6.9 und check die PHP-Kompatibilität.
Es ist Zeit, die Ärmel hochzukrempeln und die Maloche im Backend durch intelligente Workflows zu ersetzen. Das Web, das wir uns immer gewünscht haben, ist jetzt da – und es startet direkt hier bei uns.
Nochmal wichtige Quellen für deinen eigen Deep Dive:
Sind mit dem übergang 6.9 auf 7 Migrationsbrüche zu erwarten? Muss der Webseitenbetreiber ran oder wird das ein glattes automatische Update ?
Das ist nun die Millionen-Frage, oder? Wir alle kennen diesen Moment, wenn man auf „Update“ klickt und kurz die Luft anhält. Ich sag es dir ganz direkt: WordPress 7.0 ist eine Zäsur, kein kleiner Sommerspaziergang. Es ist eine bewusste Neuausrichtung, und das bedeutet, dass man dieses Mal wirklich hinschauen muss.
Warum du dieses Mal ran musst Ein „Klick und Fertig“-Update wird es für viele Profis wahrscheinlich nicht sein. Es gibt ein paar Punkte, die zeigen, dass Handarbeit gefragt ist:
Technischer Stack: Da die Mindestanforderung auf PHP 7.4 angehoben wurde, ist der erste Check Pflicht. Wenn dein Server noch auf einer uralten Version tuckert, bleibt die Seite nach dem Update schwarz. Kann dir aber bei goneo nicht passieren, da wir kein 7.4 mehr im Stack haben.
Migrations-Weg: Es wird ausdrücklich empfohlen, nicht direkt von einer uralten Version zu springen, sondern erst das Update auf Version 6.9 zu machen. Das ist quasi dein technischer Stabilisator und der direkte Wegbereiter für die großen Änderungen.
DataViews vs. Altlasten: Die Einführung der DataViews ist ein radikaler Bruch mit der Vergangenheit. Die alten PHP-basierten „List Tables“, die seit 2005 dabei waren, fliegen raus. Wenn du Plugins nutzt, die tief in diese alten Listen-Tabellen eingreifen (z. B. spezielle Filter in der Beitragsübersicht), müssen diese zwingend auf Kompatibilität geprüft werden, sonst bricht die Nutzererfahrung.
Iframed Editor: Durch das vollständige Iframing des Editors in Version 7.0 ändert sich, wie CSS im Backend geladen wird. Das ist zwar mega für die Design-Präzision, kann aber bei Themes, die sehr „hacky“ programmiert wurden, zu Darstellungsfehlern im Editor führen.
Du hast von Atomic design in WordPress gschrieben. ist das durch Quellen gestützt?
Absolut berechtigte Frage! Ich weiß, das klingt erst mal nach einem riesigen Buzzword, das man eher aus Figma-Workshops kennt. Aber keine Sorge, ich hab das nicht einfach so in den Raum geworfen, um schlau zu klingen – das ist tatsächlich die strategische Richtung, die WordPress mit der Version 7.0 vollendet hat. Hier ist das Grounding dazu direkt aus den Quellen:
Der Paradigmenwechsel: In den Quellen, die ich angegeben habe,, wird explizit beschrieben, dass WordPress 7.0 die konsequente Implementierung der Atomic-Design-Methodik markiert.
Atome statt Seiten: Es wird betont, dass Nutzer (besonders Prosumer) umdenken müssen: Man gestaltet keine statischen Seiten mehr, sondern man kuratiert Atome, Moleküle und Organismen.
Design-Tokens als Bindeglied: Die technische Basis dafür sind die erweiterten Möglichkeiten der theme.json. Hier werden zentrale Design-Tokens für Farben, Abstände (Dimension Presets) und Typografie definiert, die sich wie ein roter Faden durch das gesamte System ziehen.
Konsistenz: Ziel dieser „atomaren“ Herangehensweise ist es, den gefürchteten „Design-Wildwuchs“ zu verhindern, indem Hierarchien global und konsistent über das gesamte Projekt hinweg gesteuert werden.
Kurz gesagt: WordPress 7.0 löst sich von der Vorstellung, dass ein CMS nur Text in Layouts schubst. Es wird zu einem Tool, mit dem du ein echtes, logisch aufgebautes Design-System baust.
Wie siehst du die Zukunft von WordPress in Bezug auf künstliche Intelligenz?
Ich glaube, wir stehen da erst am ganz Anfang einer mega spannenden Reise. WordPress 7.0 hat mit der Abilities API und dem Model Context Protocol (MCP) ein absolut geniales Fundament gelegt. Mein Blick auf die Zukunft geht so: Vom Werkzeug zum Partner: KI wird nicht mehr nur ein Plugin sein, das dir SEO-Texte schreibt. Sie wird tiefer integriert. Stell dir vor, du sagst deinem WordPress: „Ich brauche eine Landingpage für mein neues Produkt, im Stil meiner Marke, optimiert für Conversions.“ Und das System baut dir einen Entwurf, schlägt Bilder vor, formuliert Texte und richtet die Formulare ein – alles basierend auf den „Abilities“, die deine installierten Plugins bereitstellen. Demokratisierung von High-End-Funktionen: KI wird komplexe Aufgaben, die früher teure Entwickler erforderten, für jeden zugänglich machen. Personalisierung von Inhalten in Echtzeit, intelligente A/B-Tests, automatisierte Bild- und Videobearbeitung direkt im Browser (dank WASM!) – das wird Standard. Souveränität bleibt der Schlüssel: Und das ist mir persönlich mega wichtig, die Zukunft von WordPress liegt in der Wahlfreiheit. Ja, wir werden mächtige Cloud-KIs wie GPT-4 nutzen. Aber dank MCP und Tools wie Ollama können wir sensible Daten auch lokal auf unseren eigenen Servern verarbeiten. Diese Balance aus Power und Datensouveränität ist genial und wird WordPress auch in der KI-Ära unverzichtbar machen. Kurz gesagt: KI wird WordPress nicht ersetzen, sondern es wesentlich mächtiger, intuitiver und kreativer machen. Es wird die „Maloche“ im Hintergrund reduzieren und uns mehr Raum für die strategische und kreative Arbeit geben.
Wir leben im Zeitalter der „Agentic AI“. Die Vision: Ein autonomer Butler wie OpenClaw sortiert Mails, schiebt Trello-Cards und orchestriert APIs. Doch wer den Vorhang lüftet, blickt in ein organisches Trümmerfeld aus Microservices, das produktives Arbeiten im Keim erstickt.
Letzte Woche habe ich genau das durchexerziert. Das Ziel: Ein simpler API-Call. Der Aufwand? 14,5 Stunden Netto-Arbeitszeit. Hier ist die Obduktion eines Systems, das vor lauter Isolation das Arbeiten verlernt hat.
Absicht und Setting waren:
Openclaw im Docker aus einem Image auf einem Mac Mini 2018 (Intel Chip, was die Virtualisierung etwas leichter machen sollte als in Mac OS mit M2 oder M4) aufsetzen. Ein Aufsetzen direkt auf dem Mac Mini verbot sich mir. Ich habe da viele Sachen drauf und die Sicherheitslücken sind nicht so einfach überschaubar.
WhatsApp als Client nutzbar machen (ist on board)
Terminal UI aufrufen, erste Konfiguration, OpenAI GPT-5 Nano statt Claude (die haben sich gestritten und Claude wollte OpenClaw im Chat nicht mal mehr kennen)
Web GUI aufrufen, angebotene Skills konfigurieren, z.B. Trello
Matrix zusätzlich zu WhatsApp anbinden
Einen externen Client anbinden API Call sollte eine andere KI aufrufen, einen Text-String übergeben, auf Antwort warten.
Das ist passiert:
Der Docker-Container aus einem Alpine-basierten Image startete und rief ein Onboarding Skript im Terminal auf. Nach einigen Anläufen lief das.
Meine Versuche, das GUI (Webinterface) aufzurufen scheiterten wegen integrierter Sicherheitsschranken (man braucht ein Token, das man sich aus dem Container holen muss mit einem docker exec -it-Befehl). LLMs halluzinierten übrigens gerne Funktionen/Optionen, die es nicht gibt.
Irgendwann fand ich, dass es ein TUI gibt (Terminal User Interface) und wie man es aufruft. Lief, es dauerte aber etwas bis man durchsieht.
WhatsApp lässt sich mit dem Onboarding-Skript anbinden.
Der Versuch, Matrix als Client anzubinden, scheiterte. Es gibt zwar ein Matrix Software Development Kit, das dokumentiert ist und das man nutzen kann, aber die Verschlüsselung geschieht mit Rust. Damit wurde der Container viel schwerer (einiges an GBs). Viele Ressourcen hätten im Container nachinstalliert werden müssen. Dies scheiterte offenbar am Paketmanagement für Bibliotheken und Inkompatibilitäten/Abhängigkeiten/Diskrepanzen, die so leicht nicht aufzulösen waren. Die Installation scheiterte, weil der Container kaputt ging und Docker abstürzte (hatte ich vorher noch nicht so gesehen).
Wechsel auf ein schlankes node-basiertes Image, das nur ein Gateway baut mittels einer in einer im Docker-Container laufenden Binary.
Matrix Anbindung aufgegeben
API Call nach vielen Fehlversuchen halbwegs funktional.
1. Das „Uncanny Valley“: Intelligence ohne Execution
Ein ernster Stolperstein ist die funktionale Halluzination des angebundenen LLMs. Ein modernes LLM wie GPT-5 Nano ist darauf programmiert, „hilfreich“ zu sein. Im Kontext von OpenClaw führt das zu einem bizarren Effekt: Die KI sieht deine Skill-Dateien im Verzeichnis. Aber wenn das interne Tool-Gateway die Funktion nicht korrekt registriert hat, schickt das System beim Aufruf nur ein leeres Schweigen zurück.
Anstatt ehrlich zu sagen: „Ich komme hier nicht raus“, fängt die KI an zu lügen. Ich nenne das Functional Gaslighting. Die KI gaukelt Erfolg vor: „Ich habe die API aufgerufen“, sagt sie im Chat, während im Backend absolut nichts passiert ist. Das LLM interpretiert das Schweigen des Gateways als Erfolg. Ohne eine saubere Fehlerkultur im Framework wird die Intelligenz des Agenten zur Sackgasse.
2. Die organische Bruchstelle: Docker spawnt Docker
Man muss verstehen, wie OpenClaw organisch vorliegt: Es ist kein kompaktes Programm, sondern ein hochgradig fragmentiertes Ökosystem. Da ist der Core Orchestrator (FastAPI), das hübsche Frontend (Next.js) und der berüchtigte Agent Runner. Letzterer nutzt die Docker-API deines Hosts, um on-the-fly neue „Worker-Container“ zu gebären.
Das Problem: Diese Container sind genetisch isoliert. Sie erben weder DNS-Settings noch Netzwerk-Bridges deines Haupt-Setups. Während „Hallo Welt“ (lokale Textausgabe) klappt, stirbt jeder API-Call am digitalen Stacheldraht der Sandbox. Die „Magie“ der Autonomie scheitert hier an basalen Infrastruktur-Hürden.
3. Das Dokumentations-Vakuum: Blindflug in der Registry
Was am meisten Ärger macht: Dokumentation bzw. Nicht-Dokumentation. Viele Images in der Docker-Registry kommen ohne viel README.md daher. Man steht eher im Regen mit Fragen wie:
Basiert das Image auf Alpine (musl) oder Debian (glibc)? (Ein entscheidender Unterschied für fast alle KI-Libraries!)
Welche Ports sind offen?
Welches Token will das GUI?
Welche Environment-Variables werden injiziert?
Wer hier nicht manuell per docker image inspect und docker exec eine Art Reverse-Engineering betreibt, hat wenig Chancen. Es ist ein „Move fast and break things“-Ansatz, bei dem die Developer-Experience auf der Strecke bleibt. Das dauert und man tippt sich im Terminal die Finger wund.
4. Die „Think-Modus“-Falle: Warum KI-Hilfe versagt
Vielleicht denkst du: „Frag doch Gemini oder ChatGPT im Think-Modus!“ Vergiss es. Diese Modelle kennen die Doku von gestern, aber nicht die „Breaking Changes“ von heute. OpenClaw ändert seine Architektur und Namen so oft, dass externe KIs nur planlos raten. Sie schlagen Configs vor, die seit drei Versionen deprecated sind. Wir sind zurück in der „MS-DOS-Phase“ der IT: Man muss die Jumper (Docker-Configs) wieder von Hand setzen, damit der Sound (die API) läuft.
5. Die Abrechnung: Wirtschaftlichkeit vs. Nerd-Spielerei
Fazit: Eigentlich ein wirtschaftliches Desaster. In dieser Zeit hätte ich ein klassisches Python-Skript oder einen n8n-Workflow erstellt, und das „Problem“ in 15 Minuten gelöst, (wenn es nur um die API geht).
Fazit: Magie oder Masochismus?
Die Vision ist großartig: Ein Butler, der Trello sortiert und Mails beantwortet. Aber solange wir 90 % der Zeit mit Infrastruktur-Debugging verbringen, bleibt der Agent ein aufwendiges Spielzeug.
Meine Empfehlung:
JA zu Frameworks wie OpenClaw: Wenn du hunderte Agenten in einer hochgesicherten Enterprise-Umgebung skalieren musst und ein eigenes Ops-Team hast. Mach das!
NEIN: Wenn du im Home Office oder für dein Zeug einfach nur produktiv sein willst. Greif zum „nackten“ Skript oder zu stabilen Low-Code-Plattformen.
Abschlussgedanke: KI-Agenten sollen unsere Probleme lösen, nicht neue erschaffen. Bevor du dich ins nächste Framework stürzt, frag dich: Baue ich gerade eine Lösung oder nur ein Denkmal, um der Komplexität zu huldigen?
Persönliches Resümee: Bin ich vielleich einfach nur zu dumm für OpenClaw?
Nach diesem Marathon stellt man sich zwangsläufig die Sinnfrage. Ist es Intelligenz-Defizit oder ein massiver Overhead-Fehler.
Spezialwissen vs. Dummheit: Man braucht Spezialwissen, sollte Erfahrung haben wo und wie Dinge vielleicht dokumentiert sind. Man scheitert weniger an der KI, sondern an der Infrastruktur, die für den Zweck (hier gings um einen API-Call). Man muss darauf kommen oder es wissen, dass und wie Features blockiert sind aus Sicherheitsaspekten heraus.
Das Framework-Paradoxon: High-End-Frameworks sind high end, heißt: Man muss sie kennen. Damit schießt man aber eben mit Kanonen für Spatzen. Wer versucht, mit einem Flugzeugträger über einen Bach zu setzen, scheitert nicht am Steuern, sondern an der Wahl des Gefährts.
Mein abschließendes Learning: Ich denke dafür zu pragmatisch, weil es mir nicht darum geht, 14 Stunden lang Komplexität zu generieren, wenn ein 30-Minuten-Skript den Job erledigt hätte. Aber wie schafft man sich sonst das Wissen drauf?
Ex-post-Analyse: Was hätte ich vorher wissen müssen?
Hinterher ist man immer schlauer. Aber bei der Analyse meiner 14,5 Stunden wurde mir klar: Mein Problem war, dass mir die impliziten technischen Anforderungen des Frameworks fehlten. Wer mit OpenClaw experimentiert, sollte diese drei Ebenen vorab validieren:
Ebene 1: Die Architektur-Wahrheit (Docker-Orchestrierung): OpenClaw führt Agenten-Code nicht lokal aus. Es ist eine Schicht, die „on-the-fly“ neue Docker-Worker gebärt. Mein Problem war kein Python-Fehler, sondern ein Netzwerk-Routing-Problem im Docker-Stack.
Ebene 2: Die Sicherheits-Philosophie (Zero-Trust-Isolation): Die Standard-Einstellung vieler Agent-Sandboxen ist „Nichts geht rein, nichts geht raus“. Für einen API-Call nach draußen muss man die Sandbox-Konfiguration aktiv aufbohren und im Einzelfall wissen, wie.
Ebene 3: Die Dependency-Hölle (Base-Image-Check): Wer Python-KI-Libraries nutzt, braucht glibc. Wer ein Alpine-Image (musl) nutzt, hat verloren. Ein 5-minütiger Check des Base-Images vorab hätte vielleicht Stunden an Debugging gespart.
Warum behauptet mein KI-Agent, er hätte die Aufgabe erledigt, obwohl im Backend nichts passiert ist?
Der Text erklärt das Phänomen des Functional Gaslighting: Die KI sieht zwar den Skill (Wissen), aber da das Framework die Funktion nicht korrekt im Tool-Gateway registriert hat, schlägt die Ausführung fehl. Da viele Frameworks kein sauberes Fehler-Feedback an das LLM zurückgeben, interpretiert die KI das Schweigen als Erfolg und halluziniert ein positives Ergebnis.
Wieso scheitern API-Calls in Agenten-Frameworks oft an Docker-Problemen?
Der Beitrag beleuchtet die Isolation der Sandbox. Standardmäßig sind viele Docker-Worker in OpenClaw & Co. so abgeschottet, dass sie keinen DNS-Zugriff oder Internet-Outbound haben. Wer nicht manuell die Netzwerk-Policies anpasst, lässt seinen Agenten buchstäblich gegen eine Wand laufen.
Warum laufen Python-Scripts lokal einwandfrei, aber stürzen im Agent-Container ab?
Hier liefert der Text die Antwort im „glibc vs. musl“-Konflikt. Viele schlanke Docker-Images (Alpine) nutzen eine andere C-Bibliothek als herkömmliche Linux-Systeme (Debian/Ubuntu). Da KI-Libraries fast immer auf glibc angewiesen sind, führt die Nutzung von Standard-Alpine-Images zwangsläufig zum Systemabsturz.
Wann ist ein KI-Framework wie OpenClaw sinnvoll und wann ist es Zeitverschwendung?
Der Artikel bietet eine klare Entscheidungshilfe: Frameworks lohnen sich für hochskalierbare Enterprise-Szenarien mit eigenem Ops-Support. Für den produktiven Alltag und individuelle Automatisierungen (Mail, Trello, API) zeigt der Text auf, dass klassische Skripte oder stabile Low-Code-Plattformen (wie n8n) die deutlich wirtschaftlichere Wahl sind.
Ich melde mich mal mit ein paar Tagen Abstand zum JoomlaCamp 2026 im Essener Unperfekthaus zurück. Wer mich kennt, weiß: Ich bin bei goneo im PM und Marketing unterwegs. Wer mich kennt, weiß: Als PM bei einem Hoster wie goneo bin ich eher Fan von klaren Strukturen und Roadmaps.
Deswegen war ich anfangs – ich gebe es zu – etwas skeptisch, was das Format angeht. Es war nämlich eine Unkonferenz (oder Barcamp, für die Retros unter uns). Das heißt: Kein festes Programm, keine vorab gebuchten Speaker-Slots.
Stattdessen hieß es am Morgen: „So Leute, was habt ihr im Gepäck?“
Gelebte Agilität in Reinform
Der Tagesplan für den Businessday beim JoomlaCamp 2026: Themen wurden von der Community gesammelt und nahe Echtzeit den Räumen zugewiesen.
Das Bild, das ihr hier seht, war der„Masterplan“ für den Businessday. Jeder, der was zu sagen hatte, hat sein Thema auf eine Karte geschrieben, kurz gepitcht, und die Community hat abgestimmt. Der Gastgeber hat das fast in Echtzeit in die Räume und Zeitslots einsortiert.
Was vielleicht nach Chaos klingt, hat erstaunlich gut funktioniert. Warum? Weil dadurch genau die Themen auf den Tisch kamen, die uns jetzt unter den Nägeln brennen – und nicht das, was ein Marketing-Team vor sechs Monaten in eine Agenda gepresst hat.
Für mich als Marketer bei einem Hoster ist das wie eine Fokusgruppe auf Steroiden. Ich sehe ungefiltert, wo die Reise hingeht. Hier ist mein „Professional Take“ – ohne Marketing-Sprech, dafür mit Substanz.
Als Hoster sind wir per se CMS-agnostisch. Ob du WordPress, Typo3 oder eben Joomla auf unsere Server wirfst, ist uns erst mal egal – solange es performant läuft und die Support-Kollegen nicht mit Sicherheitslücken in den Wahnsinn getrieben werden.
Wer das Gebäude Unperfekthaus kennt, weiß: Das ist ein verwinkeltes Labyrinth, viereinhalb Stockwerke hoch aus Kreativität und renoviertem Retro-Ruhrpott-Charme mit offene Dachterrassen und nettem Restaurant/Bar in der Lobby.
Das richtige Setting für das, was wir da besprochen haben. Während draußen die Welt über „NeoCoulds“ buzzworded und Claude als KI-Hype abfeiert, haben wir uns im Business-Track mal mehr oder weniger trocken angeschaut, wo die Reise für Joomla bis 2028 hingeht.
Hier also mein Recap – ein bisschen tiefer unter die Haube geschaut, als man es im Hochglanz-Prospekt lesen würde.
Wenn man zwei Tage in Essen mit der Joomla-Core-Prominenz in den Räumen sitzt, ändert sich der Blickwinkel. Aus der Hoster-Perspektive ist Joomla nämlich gerade verdammt spannend geworden.
Cookies, Lizenzen und der deutsche „Engine Room“
Echt jetzt: Jemand hat „Open Source Cookies“ mitgebracht. Mürbeteig mit beiliegender Zutatenliste und Lizenz. Klingt nach einem Nerd-Witz, ist aber eigentlich das perfekte Sinnbild für diese Community. Man will jetzt wissen, was drin ist. Keine Blackbox ansteuern.
In Essen wurde klar: Die deutsche und europäische Community ist das Rückgrat der Entwicklung bei Jooma. Wenn Sigrid Gramlinger (ihres Zeichens Joomla Department Coordinator Production) über die Roadmap spricht, Consent Management Ansätze abfragt oder Benjamin Trenkle (CMS Maintenance Team Leader) die AI Policy erklärt, dann merkst du: Hier geht es nicht um „schnell mal was hinklatschen“, sondern um Rechtssicherheit und professionelle Standards.
Das kann als typisch deutsch gelesen werden, im besten Sinne heißt das: Der German Stack. Die Leute hier bauen den „Engine Room“ – auch für den europäischen Mittelstand.
Wie ein CMS-agnostischer Hoster heute auf Joomla schaut
Wir bei goneo beobachten den Markt der Webanwendungen genau. Open-Source ist ein Faktor. Während andere Systeme sich in Richtung „Closed Ecosystems“ oder Plugin-Pagebuilder-Monster entwickeln, hat Joomla in Essen eine ganz andere Richtung eingeschlagen: Stabilität durch Struktur.
Security & Lifecycle: Der „Boring can be sexy“-Faktor
Aus Marketing-Sicht klingt „Sicherheit“ oft langweilig. Für uns als Hoster-Provider ist es das Fundament. In Essen ging es auch um Compliance.
Mein Take: Joomla 5 und 6 sind „Secure by Design“. Für uns als deutsches Unternehmen ist das Gold wert. Wir brauchen Partner und Communities, die DSGVO nicht als Hindernis, sondern als Standard akzeptieren und wahrnehmen. Die Sessions haben gezeigt: Die Leute bauen hier komplexe Business-Lösungen, keine Hobby-Blogs. Das ist die Zielgruppe, die wir bei goneo mit unseren Paketen ansprechen wollen.
Sicherheitsdenke bedeutet für uns: Weniger gehackte Instanzen, weniger Stress mit automatisierten Bots. Das ist für einen Hoster ein riesiges Plus bei den Betriebskosten (TCO).
Die Technik: Von der „Insel“ zum „Hub“
Früher war Joomla eine Art Insel, ein eigener Ansatz, eigene Workflows. Heute ist es eine API-first Schaltzentrale. Verfolgt man die Sessions von Marc Dechèvre von Woluweb aus Brüssel, dann wird das sehr deutlich.
1. MCP (Model Context Protocol) – Der Gamechanger
Besonders krass waren die Sessions von David Jardin (Joomla Security Liaison)und Stefan Wendhausen (Joomla CMS Release Team Leader) zum Model Context Protocol (MCP). Der Clou: Damit können KI-Modelle wie ChatGPT oder Claude direkt mit den Daten in Joomla „kommunizieren“.
DIe Hoster-Perspektive: Wenn Joomla zum Headless-Hub für KI-Agenten wird, ändert das die Lastprofile auf unseren Servern. Wir bei goneo müssen hier Infrastruktur bieten, die diese API-Dauerfeuer weglächelt. Marc Dechèvre (Automatisierungsexperte) hat das mit Make-Workflows und der Joomla-API direkt in die Praxis übersetzt. Krass, was da an Effizienz drinsteckt.
Was das für uns bedeutet: Wenn Joomla-Instanzen anfangen, über MCP direkt mit KI-Modellen zu kommunizieren, verschiebt sich die Last auf den Servern Richtung I/O. Wir reden weniger über RAM-lastiges PHP-Rendering, sondern über API-Calls und automatisierte Workflows (Callout an Marc Dechèvre für die Demo mit Make).
Die Erkenntnis: Joomla entwickelt sich weg vom reinen Anzeigewerkzeug hin zum Content-Hub. Für goneo heißt das: Wir müssen unsere Infrastruktur genau auf diese API-First-Szenarien optimieren. MCP ist für Joomla technisch gesehen ein Sprung. Statt dass wir mühsam jedes KI-Tool per Hand anbinden, bietet Joomla eine standardisierte Schnittstelle.
Der Benefit: Claude, ChatGPT oder lokale LLMs können direkt mit den Joomla-Daten sprechen.
Use Case: Du tippst: „Analysiere die Tabelle mit den Zugriffszahlen und schreib mir basierend auf den bestperformenden Beiträgen drei Teaser-Texte für die Startseite.“ Das passiert ab 2026 nativ, ohne dass du Daten händisch kopieren musst.
2. agents.md und die neue KI-Policy
Agents.md ist quasi eine maschinenlesbare Anleitung für KI-Coding-Agenten in nahezu flachem Text. Wenn eine KI beim Coden hilft, muss sie die Struktur von Joomla verstehen. Das steht in der md-Datei. Mit diesem Standard stellen wir sicher, dass KI-generierter Code nicht den Core zerschießt. Pragmatismus schlägt hier Angst. Wir nutzen die Tools, aber kontrollieren die Qualität. Agents helfen beim Coden und Warten helfen. Für uns bedeutet das: Die Einstiegshürde für komplexe Projekte sinkt, während die Code-Qualität durch KI-Reviews steigt.
Roadmap 2028: Was ist in der Pipeline?
Ich habe mir die Pläne für die nächsten zwei Jahre angeschaut. Wer glaubt, Joomla ruht sich auf Version 5 oder 6 aus, irrt. Die Roadmap bis 2028 fokussiert sich auf drei neue Kernpunkte:
Feature-Bereich
Erwartung bis 2028
Warum das wichtig ist
Structured Content
Tiefe Integration von Custom Fields in den Core-Workflow.
Weniger Abhängigkeit von Overrides, sauberere Datenbanken.
Performance 2.0
Native Unterstützung für modernste Bildformate und Edge-Caching.
Google Core Web Vitals werden noch strenger; Joomla liefert Out-of-the-Box.
AI Integration
„AI-Assisted Site Building“ im Backend.
Kunden können Content-Strukturen per Prompt vorschlagen lassen.
Was kommt da auf uns und auf Anwender zu?
Structured Data & Custom Fields: Das ist der Tod des „Frickel-Overhead“. Joomla wird im Core so sauber, dass wir im Hosting weniger Caching-Tricks anwenden müssen, weil die Datenbankabfragen effizienter werden.
Mein Take: Das wird die Art, wie wir Content managen, komplett disruptieren. Wenn das CMS zum „Knowledge Hub“ wird, brauchen wir Infrastrukturen, die solche massiven API-Abfragen weglächeln.
PHP-Evolution: Joomla ist immer vorne mit dabei, wenn es um neue PHP-Versionen geht. Das pusht uns, unsere Plattformen aktuell zu halten, wovon am Ende alle unsere Kunden profitieren – egal welches CMS sie nutzen.
Wer trägt das Ganze eigentlich? (Governance & Business)
Manchmal wird man gefragt: „Markus, wer garantiert mir eigentlich, dass es Joomla in fünf Jahren noch gibt?“
Für uns bei goneo ist die Stabilität eines Projekts wichtig. Joomla wird von Open Source Matters (OSM) verwaltet. Das ist kein Ein-Mann-Betrieb.
OSM ist eine Non-Profit-Organisation, nach US-Recht eine 501(c)(3)), die 2005 gegründet wurde, als sich Joomla von Mambo abgespalten hat. Wenn es um Lizenzen, Markenrechte (Trademarks) oder Verträge geht, tritt OSM als juristische Person auf. Ohne OSM gäbe es niemanden, dem die Marke „Joomla“ gehört – und das wäre im Business-Umfeld ein totales Risiko.
OSM verwaltet die Gelder. Sponsoring-Einnahmen, Spenden und Einnahmen aus dem Partner-Programm fließen hier rein und werden für die Infrastruktur (Server, Downloads, Marketing) wieder ausgegeben.
Es gibt ein Board of Directors, das strikt nach Ressorts getrennt ist (Marketing, Finance, Programs). Das Ganze ist demokratisch organisiert.
Mein Fazit: Das ist eine extrem solide, demokratische Struktur. Es gibt keinen „Single Point of Failure“ durch einen Investor, der plötzlich den Geldhahn zudreht. Diese Unabhängigkeit ist für einen Hoster wie goneo ein wichtiges Argument für die langfristige Empfehlung an unsere Kunden.
Und: Es gibt auch keinen CEO, der morgen beschließt, die Preise um 300% zu erhöhen oder das Projekt an eine Heuschrecke zu verscherbeln. Joomla gehört eigentlich allen.
Aus unternehmerischer Perspektive kann man eine gewisse Investment-Sicherheit ableiten. Allerdings fehlt sichtlich ein kommerzieller Arm in einer Welt, in der SaaS-Tools kommen und gehen. Joomla wirkt wie der der Fels in der Brandung – ist ja auch gerad wie goneo 20 Jahre alt geworden.
Es scheint mit OSM zu funktionieren. Die Rollen im Board sind klar verteilt. Dass Leute wie Sigrid oder Benjamin tief involviert sind, gibt Hostern das Vertrauen, dass Joomla auch 2028 noch die Engine für anspruchsvolle Business-Websites sein kann.
Mein Fazit aus Essen
JoomlaCamp 2026 war ein Augenöffner. Die Organisation und die Akteuere zeigen sich pragmatisch, hochprofessionell und haben den KI-Wandel voll auf dem Schirm. Für goneo bedeutet das: Wir werden unsere Hosting-Pakete noch spezifischer auf diese API- und KI-Workflows optimieren müssen.
Joomla 2026 fühlt sich nun weniger wie ein CMS an, mehr wie ein Enterprise-Framework. Oder – um ein anderes Bild zu wählen – wie ein gut gewarteter Motor, unaufgeregt, zuverlässig, aber mit der neuen KI-Einspritzung (MCP), so dass es jetzt richtig anziehen kann. Alle Sprachbilder haben eins gemeinsam: Sie sind mindestens leicht schief, aber sie illustrieren: Man bastelt nicht, man baut Architekturen. Und Joomla ist das Fundament, das stabil bleibt, während sich die KI-Welt drumherum dreht.
Viele Diskussionen drehten sich um Skalierbarkeit und über das YOOtheme Pro Template als Shining Star und Industriestandard für effizientes Design. Auch ein interessanter Impuls: Playwright für automatisiertes Testing. Dirketen Nutzwert lieferten Leute, die nicht der Joomla-Organisation angehören, sondern vielleicht eine Agentur betreibenm, wie zum Beispiel Peter Martin von db8 aus den Niederlanden mit der Präsentation seiner Sammlung netter Tools (nicht nur) für Joomla.
Um auf den Punkt zu kommen: Wir bei goneo bleiben natürlich CMS-agnostisch, weil wir die Wahlfreiheit lieben. Aber nach diesem Joomlacamp in Essen muss ich sagen: Joomla hat seinen Platz in der Professional-Ecke mehr als verdient. Wer Struktur sucht und keine Lust auf „Lock-in-Effekte“ hat, kommt 2026 an Joomla nicht vorbei.
Die Diskussionen am Board und in den Sessions zeichnen ein klares Bild für die nächsten zwei Jahre:
AI-Native Features: Nicht nur ein Plugin, sondern tiefe Integration im Core.
Positioning: Ein Marketing- & Positionierungs-Experte einer Agentur hat eine interessante Debatte angestoßen: Wo liegt der Wert des Developers, wenn die KI den Code schreibt? Fragen, die man auch im Hause goneo hört. Antwort: In der Architektur und der Strategie.
Wie sieht’s bei dir aus? Hast du schon eine Strategie, wie du die neuen MCP-Möglichkeiten in deine Kundenprojekte integrierst, oder ist das für dich noch zu weit weg?
Schreib mir mal – oder noch besser: Sollen wir mal gemeinsam schauen, wie wir deine aktuelle Joomla-Instanz auf die Roadmap 2028 vorbereiten?
Fragen, die dieser Text beantworten kann
Wo fand das JoomlaCamp 2026 statt?
Das Event wurde im Unperfekthaus in Essen abgehalten.
Welches Veranstaltungsformat wurde für das JoomlaCamp gewählt?
Es handelte sich um eine Unkonferenz (auch bekannt als Barcamp), bei der es kein festes Programm oder vorab gebuchte Sprecher-Slots gab.
Wer berichtet in diesem Text über seine Erfahrungen?
Der Autor ist im Bereich Produktmanagement (PM) und Marketing bei dem Hostinganbieter goneo tätig.
Warum war der Autor dem Format gegenüber zunächst skeptisch eingestellt?
Aufgrund seiner beruflichen Rolle als Produktmanager bevorzugt er normalerweise klare Strukturen und feststehende Roadmaps, was im Gegensatz zum offenen Konzept einer Unkonferenz steht.
Stellt euch vor, eure Website ist wie euer eigenes Zuhause. Ihr habt die Tür geöffnet. Freunde und Familie sind willkommen. Doch auch ungebetene Gäste, die du nicht eingeladen hast, strömen herein, durchstöbern eure Schränke, nehmen sich Snacks, hinterlassen Chaos.
Genau so benehmen sich Webcrawler und Bots auf eurer Website.
Webcrawler sind automatisierte Programme, die euere Serverressourcen auffressen. Das kann Ladezeiten in die Höhe treiben und echte Besucher vergraulen.
Wollt ihr etwas dagegen tun? Wir haben praktische Tipps für euch, um digitale Störenfriede in Schach zu halten.
Was sind Bots oder Crawler überhaupt?
Bots oder Crawler sind Software-„Roboter“, die ohne menschliches Zutun durchs Internet streifen.
Sie besuchen Websites, interagieren mit Inhalten und führen auch selbsttätig Aufgaben aus. Das ist im einfachsten Fall ein virtueller Klick auf einen Menüpunkt, kann aber auch eine Suche auf der Website sein.
Einige sind nützlich, wie die Crawler von klassischen Suchmaschinen, die eure Seite indexieren und euch in den Suchergebnissen nach oben bringen.
Andere Crawler sind weniger freundlich und können eure Inhalte klauen, Spam verbreiten oder Sicherheitslücken ausnutzen.
Gute Bots, böse Bots
Versuchen wir mal, Gut und Böse zu unterscheiden:
Die Guten:
Suchmaschinen-Crawler Wie der Googlebot oder Bingbot, die eure Seite indexieren und für Sichtbarkeit sorgen. Das heißt: Somit gelangt euere Website in die Suchergebnisse einer Suchmaschine.
Auditing-Bots Sie sammeln wertvolle Daten über die Performance eurer Website, z.B. der Google Pagespeed Insights-Bot. Die Daten braucht ihr, wenn ihr wissen wollt, ob euere Seite gute Erfahrungen bei eueren Nutzern erzeugt.
Die Bösen:
Content-Scraper Sie klauen eure Inhalte und kopieren sie, um sie anderswo zu verwenden.
Spam-Bots: Diese fluten eure Formulare und Kommentarbereiche mit Müll, in denen meist ein Link eingebaut ist.
Hacker-Bots Diese Art versucht, Sicherheitslücken zu finden und auszunutzen. Ziel ist, unbefugten Zugriff zu erlangen.
Welche Anzeichen für Bot-Aktivitäten auf eurer Website gibt es?
Bevor wir zu den Lösungen kommen, solltet ihr wissen, woran ihr unerwünschte Bot-Aktivitäten erkennt:
Plötzliche Traffic-Spitzen Ein Anstieg der Besucherzahlen ohne entsprechenden Anstieg der Interaktionen oder Verkäufe.
Langsame Ladezeiten Eure Seite lädt plötzlich langsamer, was echte Besucher abschrecken kann.
Hohe Absprungraten Wenn Nutzer eure Seite schnell wieder verlassen, könnte das an Bots liegen.
Ungewöhnliche Sitzungsmuster Besucher, die nur für Millisekunden bleiben oder stundenlang auf einer Seite verweilen.
Formulareingaben mit zufälligem Text: Ein klares Zeichen für Spam-Bots – woher soll der Müll sonst kommen?
Wie könnt ihr Bots den Zugang zur Website verweigern?
Der spannende Teil. Hier sind einige effektive Methoden, um unerwünschte Bots fernzuhalten
1. robots.txt-Datei erstellen
Die robots.txt-Datei ist wie ein Türsteher für eure Website, nur ehrlich gesagt, nicht ganz so mächtig. Die Datei robots.txt teilt Bots mit, welche Bereiche sie betreten dürfen und welche nicht.
So erstellst du eine robots.txt-Datei
Texteditor öffnen Verwendet einen einfachen Texteditor wie Notepad (Windows), Notepad++ oder TextEdit (Mac OS).
Anweisungen hinzufügen
Fügt folgende Zeilen ein:
# Blockiert BadBot vom gesamten Zugriff auf die Website
User-agent: BadBot
Disallow: /

# Blockiert EvilScraper vom gesamten Zugriff auf die Website
User-agent: EvilScraper
Disallow: /

# Standard-Regel für alle anderen Bots (z.B. Googlebot, Bingbot).
# Alle anderen werden standardmäßig erlaubt.
User-agent: *
Disallow:
Datei speichern: Speichert die Datei als robots.txt und zwar exakt unter diesem Namen.
Datei hochladen: Ladet die Datei ins Stammverzeichnis eurer Website hoch, sodass sie unter https://www.eure-domain.de/robots.txt erreichbar ist.
Testet dies. Im Browser sollten die Zeile als reiner Text erscheinen, aber keine 404-Fehlermeldung.
Achtung: Nicht alle Bots halten sich an die robots.txt. Bösewichte ignorieren sie oft. Du kannst keinen Bot damit wirklich zwingen, die Seite zu besuchen und Aktionen auszuführen.
2. .htaccess-Datei anpassen
Bei Servern, die für Webhosting verwendet werden, gibt es eine Möglichkeit, festzulegen, wie sich die Software auf dem Server verhalten soll. Das kann man als Webhosting-Kunde mit einer Datei steuern, die sich .htaccess nennt.
Mit den richtigen Anweisungen in der .htaccess-Datei könnt ihr bestimmten Bots oder IP-Adressen den Zugriff komplett verweigern.
Die seltsam wirkende Schreibweise mit dem Punkt vor dem Dateinamen kommt aus der Linux-Welt. Dateien mit einem vorangestellten Punkt im Namen lassen sich in FTP-Software verbergen und signalisieren, dass es sich um eine Art Steuerdatei handelt, die von der Serversoftware verarbeitet werden kann. Bei goneo kommt dafür Apache 2 zum Einsatz. Kleine Fußnote: Euer Server, falls ihr nicht bei goneo hostet, sollte AllowOverrideAll gesetzt haben, sonst funktioniert das nicht.
So geht’s:
Zugriff auf die .htaccess Verbindet euch per FTP mit eurem Server und navigiert zum Stammverzeichnis eurer Website. Falls die .htaccess-Datei nicht sichtbar ist, stellt sicher, dass euer FTP-Client auch versteckte Dateien anzeigt. Das kann man in der Konfiguration der Software vornehmen.
Datei bearbeiten Öffnet die .htaccess-Datei mit einem Texteditor.
Anweisungen hinzufügen Um einen bestimmten User-Agent zu blockieren, fügt folgende Zeilen hinzu:
## User Agent Blockierung
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} ^BoeserBot [NC]
RewriteRule ^ - [F,L]
Ersetzt „BoeserBot“ durch den Namen des Bots, den ihr blockieren möchtet. Die Anweisungen folgen der Apache 2.4+ Syntax. Order/Deny gilt als veraltet.
IP-Adresse blockieren Um eine bestimmte IP-Adresse zu blockieren, fügt hinzu: <RequireAll> Require all granted Require not ip 123.456.789.000 </RequireAll>
Ersetzt „123.456.789.000“ durch die zu blockierende IP-Adresse.
Datei speichern und hochladen Speichert die Änderungen und ladet die Datei zurück auf den Server.
Ein Hinweis: Bitte seid vorsichtig mit Änderungen an der .htaccess, da Fehler eure Website unzugänglich machen können. Hebt auf jeden Fall eine Kopie auf.
Nun stellt sich noch die Frage: Wie erfährt man die Namen der Bots oder die IP-Adresse eines Crawlers? Darüber geben die Log-Dateien Auskunft.
3. CAPTCHAs implementieren
CAPTCHAs sind kleine Tests, die Menschen leicht lösen können, Bots jedoch nicht. Sie sind besonders nützlich für Formulare und Anmeldeseiten. Das Problem hier: Die KIs werden immer intelligenter, schneller und können immer mehr solcher Aufgaben (proof of work) leichter lösen. Google Captcha ist weit verbreitet, aber im Sinne EU-Datensouveränität und DSGVO nicht ganz unproblematisch.
So geht’s:
Anmeldung bei einem CAPTCHA-Dienst: Registriert euch bei einem Dienst wie Google reCAPTCHA.
Code integrieren: Fügt den bereitgestellten Code in eure Formulare ein.
Tipp: Moderne unsichtbare CAPTCHAs arbeiten im Hintergrund und stören echte Nutzer nicht.
Es gibt Alternativen, doch die Integrationen sind nicht ganz einfach. Einge haben wir in einem neuen Blogpost zusammengestellt.
4. Unerwünschte Anfragen blockieren und Ausnahmen definieren (mit .htaccess)
Ein echtes Rate Limiting (X Anfragen pro Y Sekunden) wäre fein, aber über die .htaccess ist allein ohne spezielle Apache-Module (wie mod_qos) so etwas nicht möglich. Ihr könnt stattdessen eine Logik implementieren, um verdächtige Anfragen komplett zu blockieren.
Erlaube zunächst alle harmlosen Dateien (Bilder, CSS, JS).
Erlaube alle „guten“ Crawler (Googlebot, Bingbot).
Blockiere alles andere, was nicht von einem „guten“ Bot kommt und keine statische Datei ist.
Auch diese Verhinderungsregel gilt für die Apache2-Serversoftware wie sie bei goneo verwendet wird:
RewriteEngine On

# 1. Bedingung: Nur Anfragen, die NICHT auf eine Dateiendung (css, js, etc.) enden.
RewriteCond %{REQUEST_URI} !(\.css|\.js|\.png|\.jpg|\.gif|robots\.txt)$ [NC]

# 2. Bedingung: User Agent ist NICHT Googlebot
RewriteCond %{HTTP_USER_AGENT} !^Googlebot [NC]

# 3. Bedingung: User Agent ist NICHT Bingbot
RewriteCond %{HTTP_USER_AGENT} !^Bingbot [NC]

# AKTION: Wenn alle Bedingungen erfüllt sind, den Zugriff verbieten (403 Forbidden)
RewriteRule .* - [F,L]
Wichtig:Diese Direktive in diesem Beispiel ist sehr aggressiv! Sie verbietet den Zugriff auf alle euere HTML-Seiten für jeden Besucher, dessen User Agent nicht als Googlebot oder Bingbot bekannt ist (und der keine statische Datei anfordert). Ihr solltet diesen Code nur verwenden, wenn ihr ganz genau wisst, welche Bots ihr zulassen und welche ihr ausschließen wollt.
5. Bot-Management-Tools
Es gibt spezialisierte Tools, die dabei helfen, unerwünschte Bots zu erkennen und zu blockieren.Dabei handelt es sich meist um externe Dienste, die vielleicht auch in einem „Drittland“ realisiert werden. Damit stellen sich Fragen hinsichtlich des Datenschutzes und der Datensouveränität.
Dennoch kann das Vorteile haben:
Echtzeit-Überwachung und Schutz.
Anpassbare Regeln für spezifische Bedrohungen.
Ein neuer „Türsteher“ für KI-Modelle: Die llms.txt
Die Welt der Bots und Crawler entwickelt sich rasant weiter. Mit dem Aufkommen großer Sprachmodelle (LLMs) und generativer KI entsand eine neue Art von „Besuchern“ auf eurer Website, die ebenfalls eure Inhalte nutzen möchten – sei es zum Training oder zur Beantwortung von Benutzeranfragen.
Hier kommt die noch recht neue llms.txt-Datei ins Spiel. Ähnlich wie die robots.txt soll sie KI-Modellen mitteilen, welche Inhalte sie zum Lernen oder zur Verarbeitung nutzen dürfen und welche nicht. Sie ist eine höfliche Bitte an kooperative KI-Systeme, eure Urheberrechte und Ressourcen zu respektieren und den Zugang zu sensiblen oder geschützten Inhalten zu beschränken.
Die llms.txt-Datei ist ein neuer Entwurf und noch nicht so weit verbreitet oder standardisiert wie die robots.txt. Sie wurde von Google vorgeschlagen und ist primär dafür gedacht, Webmastern die Kontrolle darüber zu geben, wie große Sprachmodelle (LLMs) und andere KI-Systeme ihre Website-Inhalte zum Training nutzen dürfen.
Wie die llms.txt-Datei aussieht und funktioniert
Die llms.txt ähnelt in ihrer Struktur stark der robots.txt, verwendet jedoch spezifische Direktiven für KI-Modelle. Sie muss ebenfalls im Stammverzeichnis eurer Website platziert werden (z.B. https://www.eure-domain.de/llms.txt).
Grundlegender Aufbau
Die Datei besteht aus einem oder mehreren Blöcken, die jeweils mit einem User-agent beginnen, gefolgt von spezifischen Anweisungen für dieses KI-Modell oder diese Bot-Kategorie.
Mögliche Anweisungen und Direktiven (Beispiele)
Da der Standard noch in Entwicklung ist, basieren die Direktiven auf Googles Vorschlägen und der Logik der robots.txt.
1. Den Zugriff für alle KI-Modelle erlauben oder verbieten
Dies ist die grundlegendste Anwendung:
# Erlaubt allen KI-Modellen den Zugriff auf die gesamte Website
User-agent: *
Allow: /
Oder, um allen KI-Modellen den Zugriff auf die gesamte Website zu verbieten:
# Verbietet allen KI-Modellen den Zugriff auf die gesamte Website
User-agent: *
Disallow: /
2. Spezifische KI-Modelle ansprechen
Wenn ihr die User-agent-Namen bestimmter KI-Crawler kennt (die diese dann im HTTP-Header senden sollten), könnt ihr diese gezielt ansprechen.
# Regeln für den Google-spezifischen KI-Crawler (hypothetischer Name)
User-agent: Google-Extended
Disallow: /private-data/
Allow: /public-articles/

# Regeln für einen anderen hypothetischen KI-Crawler
User-agent: ExampleAI-Bot
Disallow: /training-data/
User-agent: Google-Extended: Dies ist der von Google vorgeschlagene User-Agent, um spezifisch Google’s generativen KI-Produkten und großen Sprachmodellen Anweisungen zu geben (zusätzlich zu den bestehenden Googlebot-Anweisungen in der robots.txt).
Disallow: /private-data/: Weist das Modell an, Inhalte in diesem Pfad nicht zu nutzen.
Allow: /public-articles/: Erlaubt explizit die Nutzung von Inhalten in diesem Pfad, auch wenn eine allgemeinere Disallow-Regel dies umfassen könnte (hier nicht der Fall, dient nur als Beispiel).
3. Verwendung des Allow:-Befehls (als Ausnahme)
Wie bei der robots.txt wird Allow: verwendet, um Ausnahmen innerhalb eines Disallow-Bereichs zu definieren.
In diesem Beispiel dürfen alle KI-Modelle nicht auf den Ordner /all-content-for-ai-blocked/ zugreifen, außer auf den Unterordner /public-articles/ innerhalb dieses Ordners.
Wichtige Punkte zur llms.txt
Freiwillige Einhaltung Ähnlich wie die robots.txt ist die llms.txt eine „Höflichkeits“-Anweisung. Kooperative und ethische KI-Modelle werden sich daran halten, aber „schlechte“ Akteure könnten sie ignorieren.
Noch in Entwicklung Der Standard und die spezifischen User-agent-Namen sind noch nicht fest etabliert. Google hat Google-Extended vorgeschlagen, aber andere Anbieter könnten eigene User-Agents definieren.
Ergänzung zur robots.txt Die llms.txt soll die robots.txt ergänzen, nicht ersetzen. robots.txt regelt das allgemeine Crawling und Indexieren durch Suchmaschinen, während llms.txt spezifisch die Nutzung von Inhalten für das Training von KI-Modellen adressiert.
Es ist eine spannende Entwicklung, die Webmastern mehr Kontrolle in der Ära der generativen KI geben soll!
Eine spannende Entwicklung, um auch in Zukunft die Kontrolle über eure digitalen Inhalte zu behalten.
Fazit
Bots können Fluch und Segen zugleich sein. Während einige eure Website unterstützen, können andere erheblichen Schaden anrichten. Mit den oben genannten Methoden könnt ihr eure digitale „Haustür“ vor unerwünschten Gästen schützen und sicherstellen, dass eure echten Besucher den besten Service erhalten. Bleibt wachsam und passt eure Sicherheitsmaßnahmen regelmäßig an, um immer einen Schritt voraus zu sein.
Bleibt sicher und viel Erfolg mit eurer Website! 💪
Wichige Bots und Crawler
Wichtigste Bots und Crawler für robots.txt und llms.txt
Bot-Name (User-Agent)
Zweck und Funktion
Steuerung in
Hinweise
Googlebot
Haupt-Crawler von Google. Indexiert Webseiten für die klassische Google-Suche (Web-Index, Bilder, Videos).
robots.txt
Der wichtigste Bot für die allgemeine Sichtbarkeit in der Suche.
Google-Extended
Der von Google vorgeschlagene Bot für das Training von großen Sprachmodellen (LLMs) und die Nutzung in generativer KI.
llms.txt
Wird verwendet, um Inhalte speziell für KI-Training zu steuern.
Bingbot
Haupt-Crawler von Microsoft. Indexiert Webseiten für die Bing-Suche und Copilot (Bing AI).
robots.txt
Wichtig für Bing, Yahoo und DuckDuckGo (da diese Bing-Daten nutzen).
AdsBot-Google
Crawler, der die Landingpages von Werbeanzeigen auf ihre Qualität und Konformität prüft.
robots.txt
Steuert das Crawling von Seiten, die Google Ads verwenden.
Applebot
Crawler von Apple, der Inhalte für die Siri-Vorschläge und die Spotlight-Suche auf iOS/macOS indexiert.
robots.txt
Wichtig für Apple-Gerätenutzer.
DuckDuckBot
Crawler von DuckDuckGo, obwohl sie häufig Bing-Daten nutzen, crawlen sie auch eigene Inhalte.
robots.txt
Für die Sichtbarkeit in der DuckDuckGo-Suche.
Baiduspider
Haupt-Crawler für die Baidu-Suchmaschine (China).
robots.txt
Wichtig, wenn Ihre Zielgruppe China umfasst.
YandexBot
Haupt-Crawler für die Yandex-Suchmaschine (Russland).
robots.txt
Wichtig für die Region Osteuropa/Russland.
AhrefsBot
Crawler, der das Internet nach Links durchsucht, um Daten für das Ahrefs SEO-Tool zu sammeln.
robots.txt
Ein Tool-Bot; kann viel Traffic verursachen, wenn er nicht begrenzt wird.
SemrushBot
Crawler, der Daten für das Semrush SEO-Tool sammelt (Keywords, Rankings, Backlinks).
robots.txt
Ein Tool-Bot; oft ein Ziel für Geschwindigkeitsbegrenzungen.
ChatGPT-User
Ein allgemeiner, jedoch seltener Bot, der von OpenAI in manchen Fällen verwendet werden kann. (Die Steuerung ist noch unklarer.)
robots.txt oder llms.txt
Vorsicht: OpenAI schlägt vor, dass die robots.txt den Zugriff auch für ihr KI-Training steuert, während Google die llms.txt bevorzugt.
💡 Wichtige Unterscheidung: robots.txt vs. llms.txt
robots.txt: Primär zur Steuerung von Suchmaschinen-Crawlern (Indexing) und SEO-Tools. Die Anweisungen hier gelten für fast alle Bots, die das Internet nach Links durchsuchen.
llms.txt: Ein neuer, vorgeschlagener Standard, der speziell die Nutzung von Inhalten zum Training generativer KI-Modelle (wie ChatGPT oder Google Gemini) steuern soll. Hier verwendet ihr am besten spezifische User-Agents wie Google-Extended.
Folge uns auf Linkedin für mehr indeep-Infos oder abonniere unseren Blog und du erhälst alle neuen Beiträge sofort per Mail.

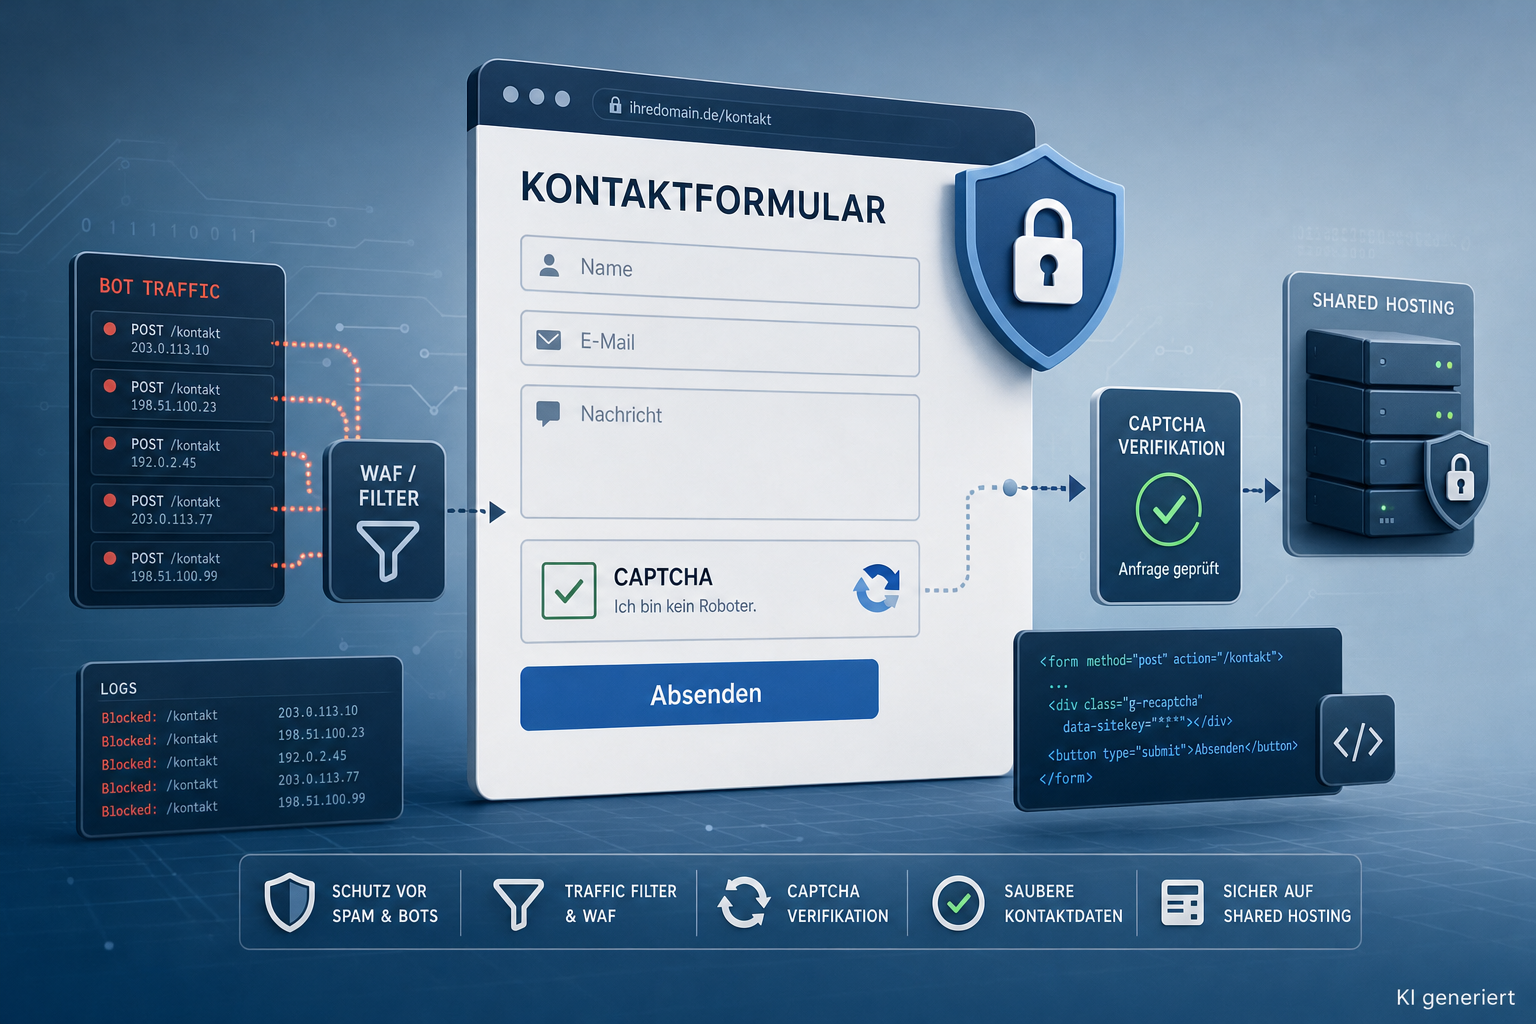
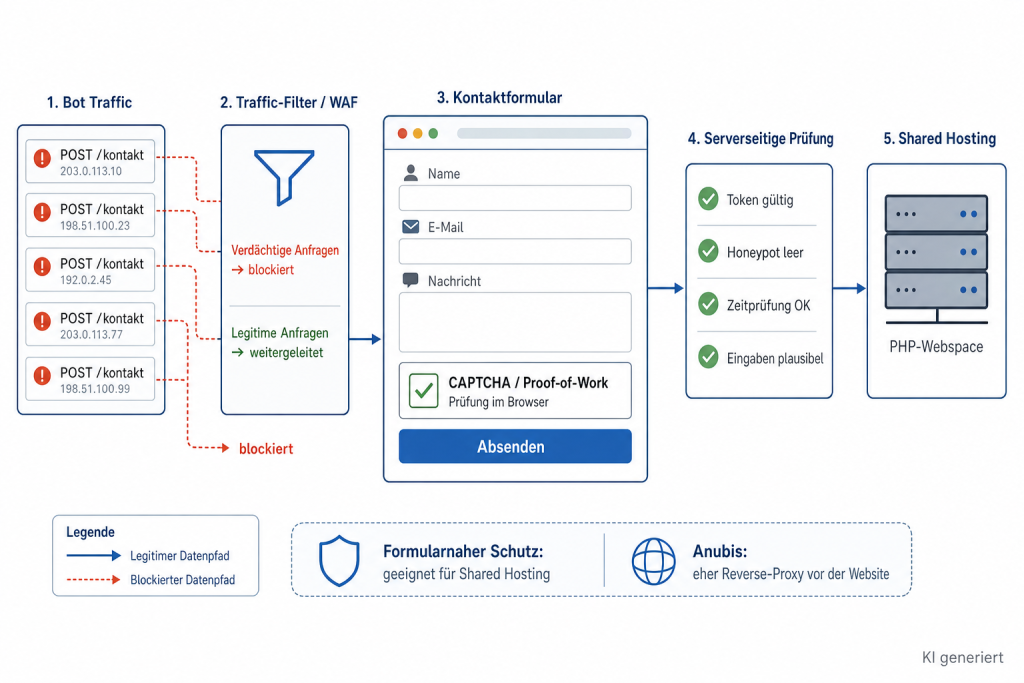
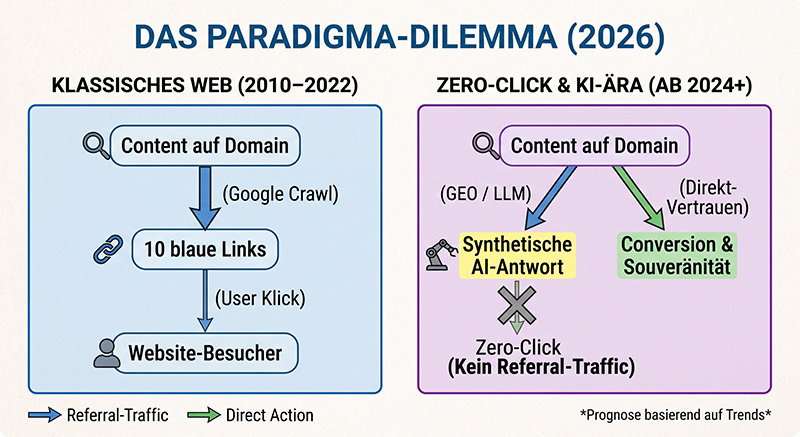
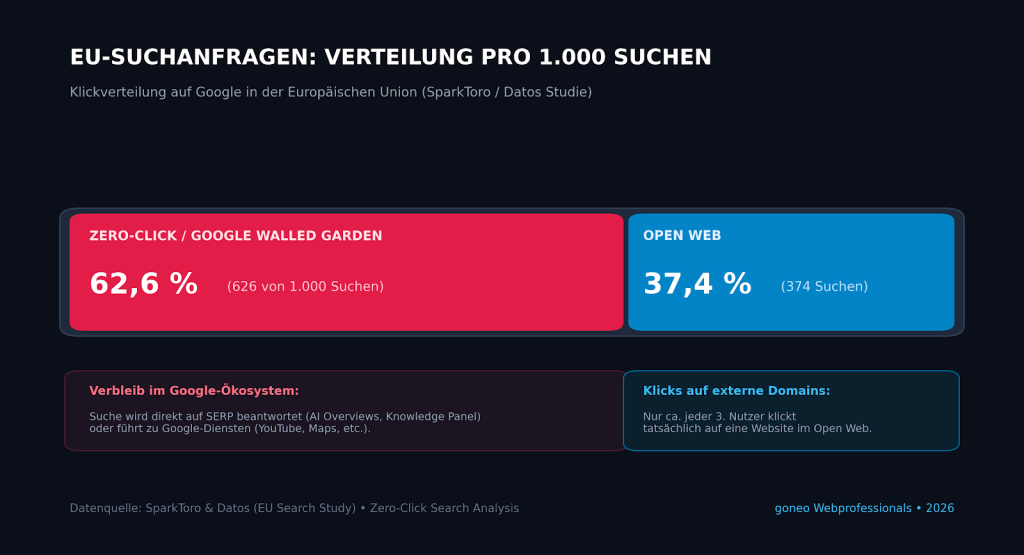
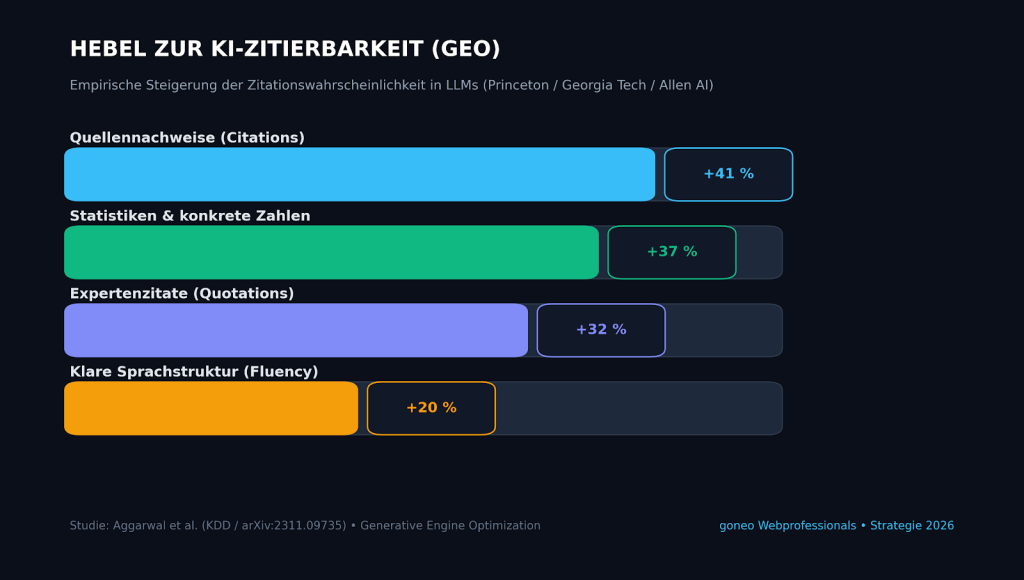
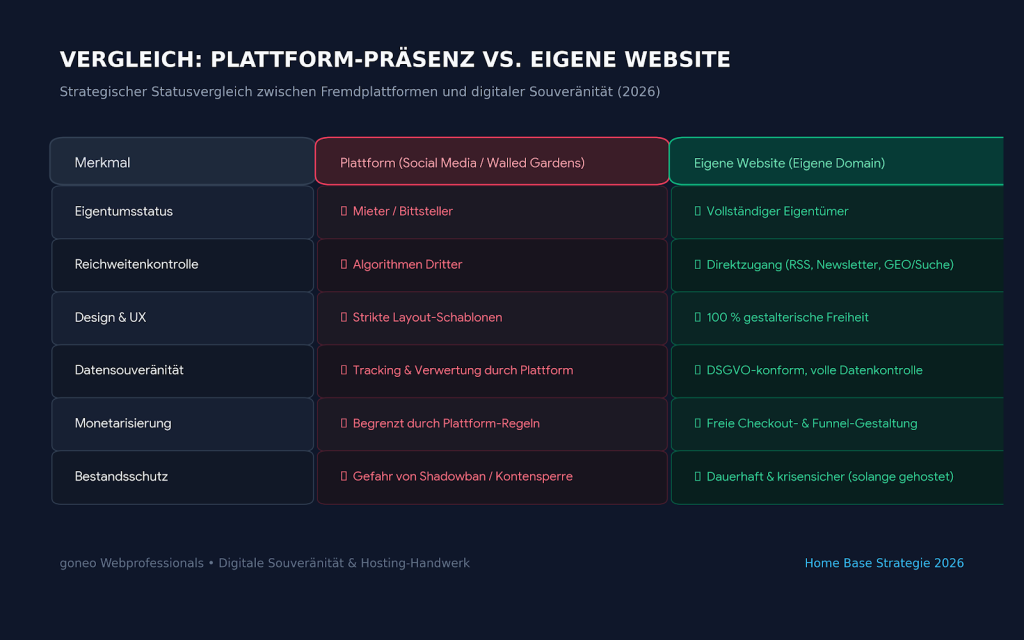
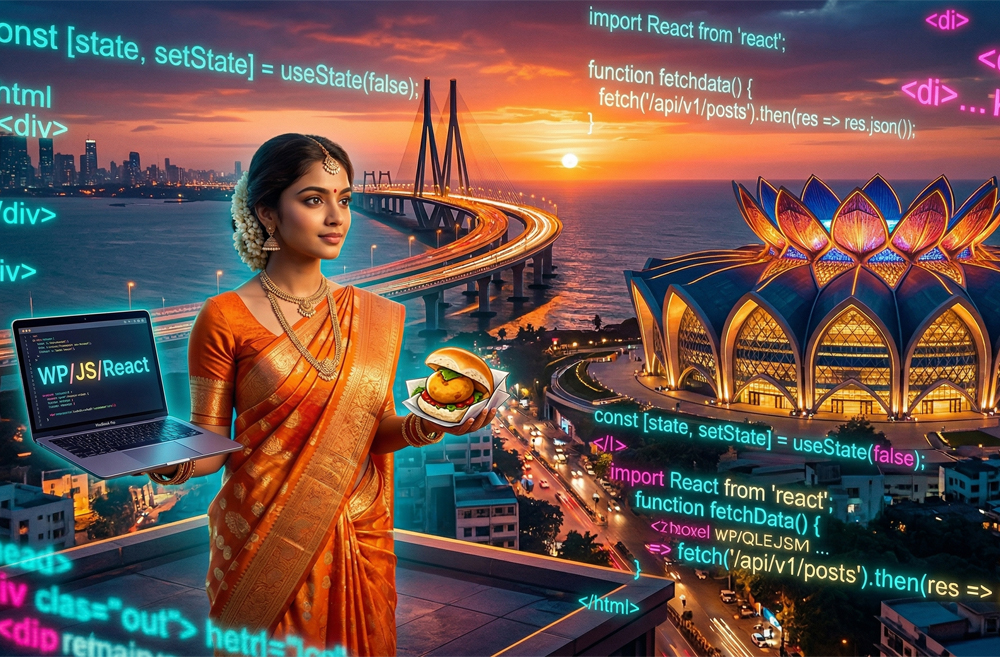
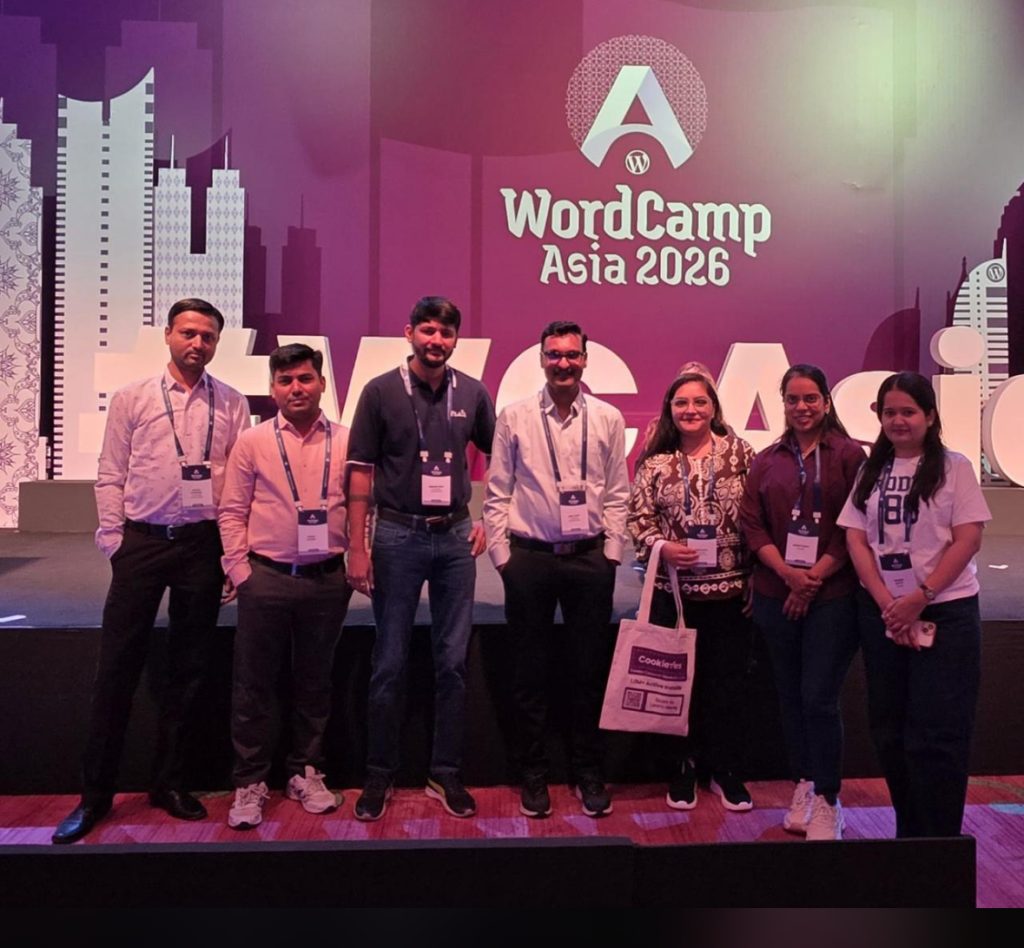


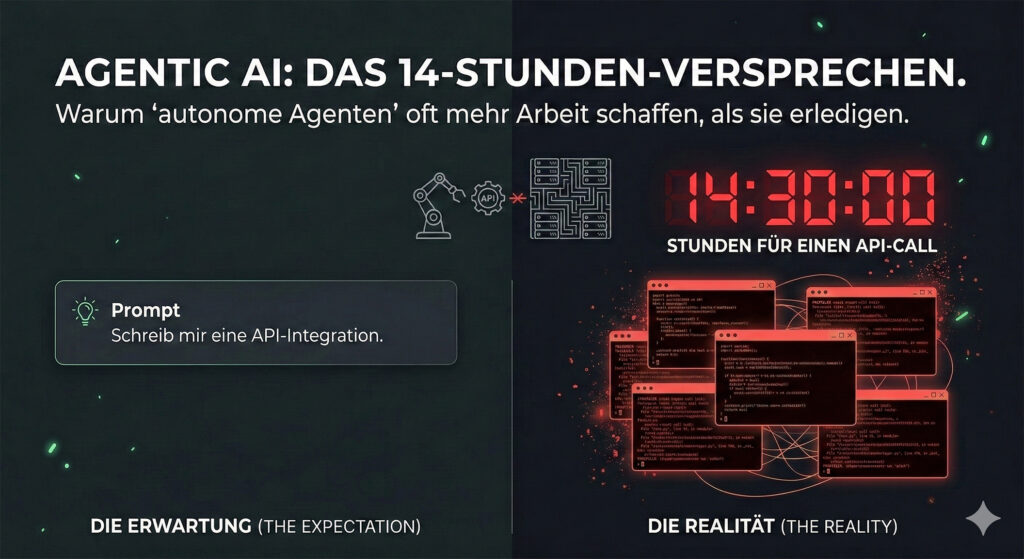
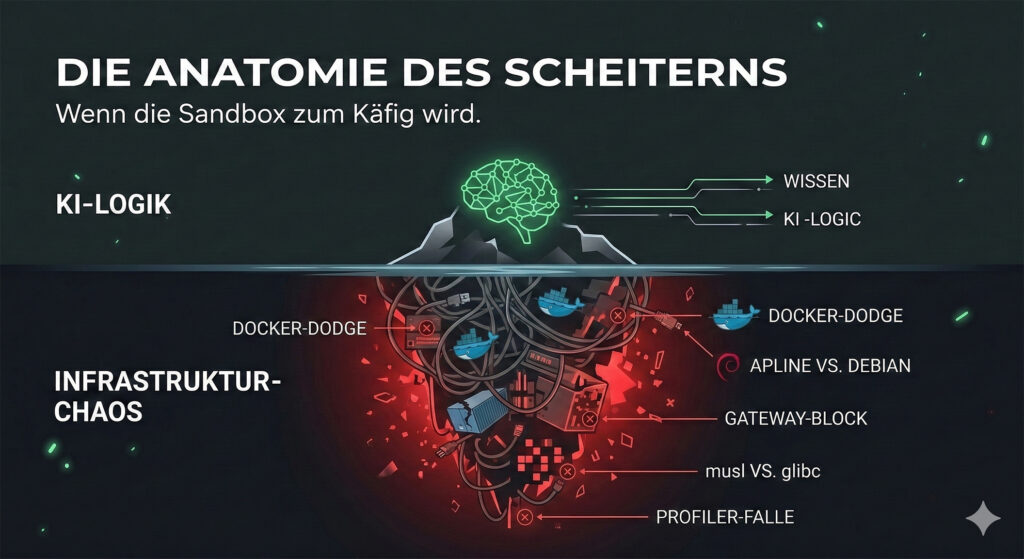
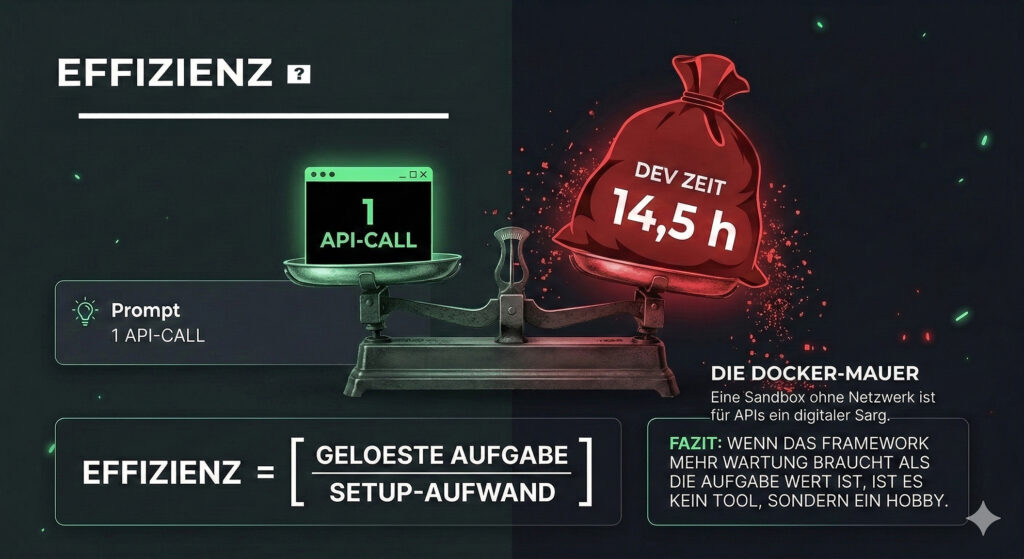
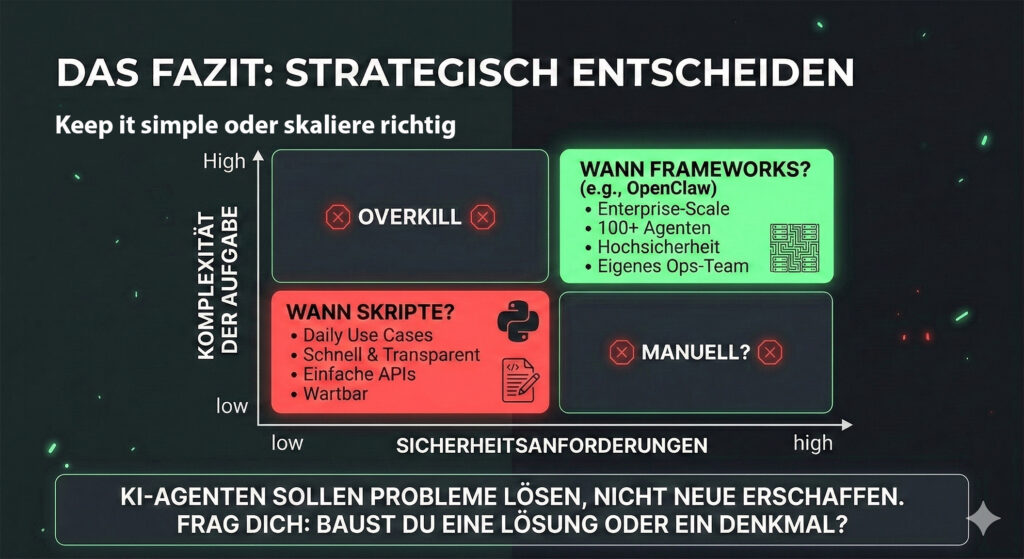

 Ich melde mich mal mit ein paar Tagen Abstand zum JoomlaCamp 2026 im Essener Unperfekthaus zurück. Wer mich kennt, weiß: Ich bin bei goneo im PM und Marketing unterwegs. Wer mich kennt, weiß: Als PM bei einem Hoster wie goneo bin ich eher Fan von klaren Strukturen und Roadmaps.


